ГОСТ Р 53556.12-2014. Национальный стандарт Российской Федерации. Звуковое вещание цифровое. Кодирование сигналов звукового вещания с сокращением избыточности для передачи по цифровым каналам связи. Часть III (MPEG-4 audio). Масштабируемое кодирование без потерь
Актуально на 01.11.2026.
Как цитировать: "ГОСТ Р 53556.12-2014. Национальный стандарт Российской Федерации. Звуковое вещание цифровое. Кодирование сигналов звукового вещания с сокращением избыточности для передачи по цифровым каналам связи. Часть III (MPEG-4 audio). Масштабируемое кодирование без потерь". ГОСТ Р 53556.12-2014. https://bukva.ai/docs/standart-gost-r-53556-12-2014
(утв. и введен в действие Приказом Росстандарта от 17.03.2014 № 149-ст)
Примечание
Документ введен в действие с 1 января 2015 года.
и метрологии
от 17 марта 2014 г. № 149-ст
НАЦИОНАЛЬНЫЙ СТАНДАРТ РОССИЙСКОЙ ФЕДЕРАЦИИ
КОДИРОВАНИЕ СИГНАЛОВ ЗВУКОВОГО ВЕЩАНИЯ С СОКРАЩЕНИЕМ
ИЗБЫТОЧНОСТИ ДЛЯ ПЕРЕДАЧИ ПО ЦИФРОВЫМ КАНАЛАМ СВЯЗИ
МАСШТАБИРУЕМОЕ КОДИРОВАНИЕ БЕЗ ПОТЕРЬ
Digital sound broadcasting. Coding of signals of sound
broadcasting with reduction of redundancy for transfer on
digital communication channels. Part III (MPEG-4 audio).
Scalable lossless coding
Дата введения 1 января 2015 года
1 РАЗРАБОТАН Техническим комитетом по стандартизации ТК 480 «Связь»
2 ВНЕСЕН Техническим комитетом по стандартизации ТК 480 «Связь»
3 УТВЕРЖДЕН И ВВЕДЕН В ДЕЙСТВИЕ Приказом Федерального агентства по техническому регулированию и метрологии от 17 марта 2014 г. № 149-ст
4 Настоящий стандарт разработан с учетом основных нормативных положений международного стандарта ИСО/МЭК 14496-3:2009 «Информационные технологии. Кодирование аудиовизуальных объектов. Часть 3. Аудио» (ISO/IEC 14496-3:2009 «Information technology — Coding of audio-visual objects — Part 3: Audio», NEQ) [1]
Правила применения настоящего стандарта установлены в ГОСТ Р 1.0-2012 (раздел 8). Информация об изменениях к настоящему стандарту публикуется в ежегодном (по состоянию на 1 января текущего года) информационном указателе «Национальные стандарты», а официальный текст изменений и поправок — в ежемесячном информационном указателе «Национальные стандарты». В случае пересмотра (замены) или отмены настоящего стандарта соответствующее уведомление будет опубликовано в ближайшем выпуске ежемесячного информационного указателя «Национальные стандарты». Соответствующая информация, уведомление и тексты размещаются также в информационной системе общего пользования — на официальном сайте Федерального агентства по техническому регулированию и метрологии в сети Интернет (gost.ru).
Данный стандарт описывает алгоритм масштабируемого кодирования без потерь MPEG-4 для аудиосигналов.
2.1 Термины
В этом стандарте используются следующие термины.
2.2 Система обозначений
Чтобы сделать описание строгим, в этом документе используется следующая система обозначений:
матрицы (и векторы векторов) обозначаются прописными однобуквенными именами, например, M;
2.3 Определения
DIV (m, n) Целочисленное деление с усечением результата m/n до целочисленного значения по направлению к — \infty .
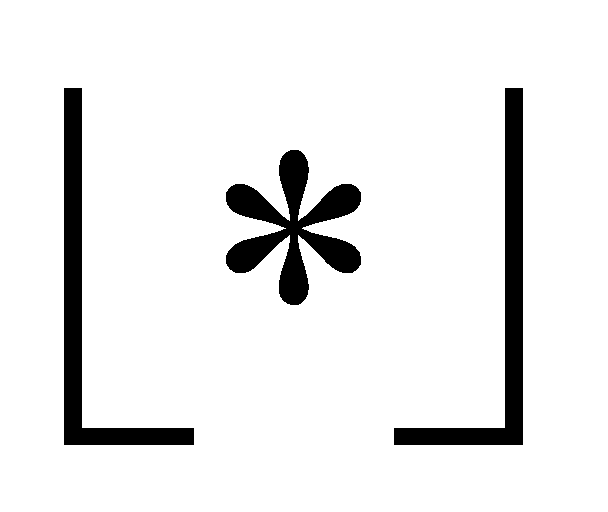 Операция floor. Возвращает самое большое целое число, которое меньше или равно аргументу с вещественным значением.
3 Полезные нагрузки для аудиообъекта
Полезная нагрузка верхнего уровня для потока lle
| Синтаксис | Количество битов | Мнемоника |
|---|---|---|
| lle_element() { for (ch=0;ch<channel_number;) { if (is_channel_pair(ch)) { lie channel pair elementO; ch += 2; } else { lle_single channel_element(); ch++; } } } |
| Синтаксис | Количество битов | Мнемоника |
|---|---|---|
| lie single channel elementO { lle_individual_channel_stream(1); } |
Синтаксис lle_individual_channel_stream
| Синтаксис | Количество битов | Мнемоника |
|---|---|---|
| lle_channel_pair_element0 { lle_individual_channel_stream(1); lle_individual_channel_stream(0); } |
| Синтаксис | Количество битов | Мнемоника |
|---|---|---|
| lle_data() { |
||
| BPGC/CBAC data | Изменяется | bslbf |
| LEMC data } |
Изменяется | bslbf |
Длина слова исходной формы сигнала PCM
| pcmWordlength | Длина слова исходной формы сигнала PCM |
|---|---|
| 0 | 8 |
| 1 | 16 |
| 2 | 20 |
| 3 | 24 |
| 4 — 7 | Зарезервировано |
| frameLength | Длина фрейма IntMDCT в уровне LLE. |
|---|
| frameLength | Длина фрейма IntMDCT | Фактор передискретизация банка фильтров IntMDCT (osf) |
|---|---|---|
| 0 | 1024 | 1 |
| 1 | 2048 | 2 |
| 2 | 4096 | 4 |
| 3 — 7 | Зарезервировано | Зарезервировано |
| Значение band_type_signaling | Тип полосы |
|---|---|
| 00 | Используется по умолчанию |
| 01 | Сигнализация о типе полосы для каждого sfb следует |
| 10 | Все sfb являются Explicit_Band |
| 11 | Зарезервировано |
| Значение | Тип полосы |
|---|---|
| 0 | Explicit_Band |
| 1 | Значение по умолчанию |
| cb_cbac | Таблица частот |
|---|---|
| 0 | BPGC |
| 1 | CBAC |
| bpgc/cbac_data | Двоичный поток битов кодированных спектральных данных остатка bpgc/cbac. |
|---|---|
| low_energy_mode_data | Двоичный поток битов кодированных данных спектра остатка режима LEMC. |
5.1 Обзор
Поток базового уровня MPEG-4 GA декодируется детерминированным декодером базового уровня. Его вывод, который является детерминированным спектром в области MDCT, отправляется в инверсный процесс отображения ошибок. Тем временем остаточный спектр IntMDCT, который переносится в потоках уровня LLE, декодируется и отправляется в инверсный процесс отображения ошибок, чтобы восстановить спектр IntMDCT. Затем вызывается и выполняется в случае необходимости на коэффициентах IntMDCT процесс инверсного целочисленного Mid/Side (M/S) и инверсного целочисленного TNS. Наконец, его вывод инверсно преобразовывается при использовании инверсного процесса IntMDCT, чтобы получить аудиовыборки PCM. Подробное описание каждого процесса дается в последующих разделах.
5.2 Метод передискретизации
Базовому уровню разрешено работать на более низкой частоте дискретизации, чем уровням LLE. Следующая таблица показывает некоторые возможные комбинации частоты дискретизации.
Масштабируемость кодека, использующего различные частоты дискретизации, достигается, изменяя длину инверсного IntMDCT в декодере, соответственно. В то время, как ядро AAC обрабатывает 1024 значения в каждом фрейме, кодек SLS должен обработать osf1024 значений на фрейм. Это достигается увеличением длины инверсного IntMDCT в декодере до osf1024 линий спектра. 1024 значения инверсного квантованного спектра из ядра AAC добавляются к 1024 низкочастотным значениям спектра остатка SLS.
5.3 SLS с ядром масштабируемого AAC
Если базовым уровнем является AAC Scalable, спектральные данные, декодируемые из уровней SLS, добавляются к спектральным данным, декодируемым из потоков масштабируемого AAC детерминированным инверсным квантизатователем AAC. Получающиеся спектральные данные затем обрабатываются инверсным целочисленным M/S и инверсным целочисленным процессом TNS в случае необходимости. Наконец вывод преобразовывается инверсным IntMDCT, чтобы выработать аудиовыборки PCM.
5.3.1 Неосновной режим
В неосновном режиме SLS работает как автономный кодек без ядра AAC. В случае аудиообъектного типа SLS это сообщается с помощью aac_core_present = 0 для неосновного режима и aac_core_present = 1 для режима на базе ядра. В случае неосновного аудиообъектного типа SLS это всегда aac_core_present = 0.
В неосновном режиме используются следующие значения по умолчанию:
- window_shape = 0 (синусное окно);
- если (lle_channel_pair_element) common_window = 1 (включено);
- если (use_stereo_intmdct), все флаги M/S включены, иначе все флаги M/S выключены;
- если (window_sequence = = EIGHT_SHORT_SEQUENCE) группировка = {2,2,2,2}.
5.4 Декодирование lle_single_channel_element (LLE_SCE) и lle_channel_pair_element (LLE_CPE)
5.4.1 Определения
5.4.2 Процесс декодирования
5.4.2.1 LLE_SCE и LLE_CPE
LLE_SCE составляется из lle_individual_channel_stream (LLE_ICS), в то время как у LLE_CPE имеется два lle_individual_channel_streams (LLE_ICS).
5.4.2.2 Декодирование LLE_ICS
В LLE_ICS порядок процесса декодирования следующий.
Взять lle_ics_len, информацию со стороны декодируемой LLE, BPGC/CBAC и LEMC.
Для потока битов SLS, составленного из потока lle_main (lle_main_stream = 1) и многократного (>= 1) потока lle_extension (lle_main_stream = 0) для каждого LLE_ICS, создается lle_data (), связывая элементы lle_data () из потока lle_main, и всех доступных потоков lle_extension.
Если промежуточный поток LLE_extension отсутствует, данные в lle_data () последующих потоков не могут использоваться.
5.4.2.3 Восстановление дополнительной информации BPGC/CBAC
Поскольку каждая полоса масштабного коэффициента полосы типа Explicit_Band передается максимальная разрядная матрица (max_bp). Кроме того для каждой полосы масштабного коэффициента разрядная матрица lazy (lazy_bp) передается, если все остаточные спектральные данные не являются нулевыми для этой полосы масштабного коэффициента (о чем сообщается максимальной разрядной матрицей = -1). max_bp кодируется, используя кодированное DPCM переменной длины относительно ранее переданной максимальной разрядной матрицы. Первое значение в каждой группе окон кодируется, используя PCM на 5 битов. Значение max_bp кодируется в унарном представлении. Следующая таблица дает некоторые примеры того, как кодируется значение DPCM max_bp.
Кодовая комбинация для декодирования значения DPCM max_bp
| DPCM max_bp | Кодовая комбинация | Длина кодовой комбинации |
|---|---|---|
| 0 | 1 | 1 |
| (s)1 | 01(s) | 3 |
| (s)2 | 001(s) | 4 |
| ... | ... | ... |
| (s)10 | 00000000001 (s) | 12 |
| ... | ... | ... |
Различие между max_bp и lazy_bp, значение которого лежит в пределах диапазона {1, 2, 3}, декодируется следующим образом:
Кодовая комбинация для декодирования различия между max_bp
и lazy_bp
| max_bp — lazy_bp | Кодовая комбинация | Длина кодовой комбинации |
|---|---|---|
| 1 | 10 | 2 |
| 2 | 0 | 1 |
| 3 | 11 | 2 |
Следующий псевдокод иллюстрирует процесс декодирования для max_bp и lazy_bp.
for (g = 0;g < num_window_groups; g++)
init = 0;
for (sfb = 0; sfb <num sfb+num osf sfb;sfb++){
if (band type[g][sFb]== Explicit Band) {
if (!init){
max bp[g][sfb] = read bits(5) — 1;
init ++;
            }
        else {
            m = 0;
            while (read_bits(1) == 0) m++;
            if (m) {
                      if (read_bits(1)) m = -m;
            }
            max_bp[g][sfb] = m0 - m;
        }
        m0 = max_bp[g][sfb];
}
if (max_bp[g][sfb]>=0) {
    if (read_bits(1)==0)
            lazy_bp[g][sfb] = max_bp[g][sfb] - 2;
        else {
            if (read_bits(1)= =0)    lazy_bp[g][sfb] = max_bp[g][sfb] - 1;
            else lazy_bp[g][sfb] = max_bp[g][sfb] - 3;
            }
        }
    }
Для Implicit_Bands, max_bp [g] [sfb] вычисляется из порогов квантования квантователя базового уровня следующим образом:
Как первый шаг может быть вычислена максимальная разрядная матрица M для каждого спектрального бункера остатка для существенных полос масштабного коэффициента с помощью
M [g] [win] [sfb] [bin] = INT {log2[interval [g] [win] [sfb] [bin]]}.
где interval [g] [win] [sfb] [bin] является интервалом квантования, который дается как:
interval [g] [win] [sfb] [bin] = thr (guant [g] [win] [sfb] [bin] + 1) — thr (guant [g] [win] [sfb] [bin] + 1).
Здесь thr (x) и inv_quant (x) являются соответственно детерминированным порогом квантования и соответствующим детерминированным инверсным квантованием для квантователя AAC. Они вычисляются в следующем псевдокоде:
thr(x) = (thrMantissa(|x|-1, scale res)) << (12+ scale int);
inv_quant(x) = (invQuantMantissa(|x, scale_res)) << (12+ scale_int);
scale_res = scale — scale_int*4, и
scale=scale_factor(sfb)+core_scaling_factor+scale_osf-118.
Величина core_scaling_factor дается в таблице 17.
Таблица для core_scaling_factor
 |
16 | 20 | 24 |
|---|---|---|---|
| Длинное окно (2048), M/S | 0 | 16 | 32 |
| Длинное окно (2048), не M/S | 2 | 18 | 34 |
| Короткое окно (256), M/S | 6 | 22 | 38 |
| Короткое окно (256), не M/S | 8 | 24 | 40 |
| osf | 1 | 2 | 4 |
|---|---|---|---|
| scale_osf | 0 | 2 | 4 |
Для полос масштабного коэффициента, кодированных с помощью IS или PNS, значение inv_quant (x) устанавливается в 0.
Максимальная разрядная матрица max_bp для каждого sfb является максимальным значением M для спектральных данных, которые принадлежат этому sfb:
max_bp [g] [sfb] = max (M[g][win][sfb][bin])
5.5 Декодирование lle_data
5.5.1 Определения
5.5.2 Процесс декодирования
5.5.2.1 Краткий обзор
Целочисленный вектор данных спектра остатка декодируется из потока данных LLE lle_data (). Во-первых все полосы масштабного коэффициента с lazy_bp > 0 являются декодируемыми BPGC/CBAC, где амплитуда и знак данных спектра остатка res являются декодируемой разрядной матрицей, начиная с максимальной разрядной матрицы max_bp и продолжая с нижними разрядными матрицами до разрядной матрицы 0 для каждой полосы масштабного коэффициента. Потом вызывается декодирование режима низкой энергии, чтобы декодировать остающиеся полосы масштабного коэффициента с lazy_bp <= 0.
Декодер SLS может обеспечить функциональность мелкоструктурированной масштабируемости (FGS), усекая поток битов LLE. Кроме того это позволяет декодировать дополнительные символы вне точки усечения, используя свойства арифметического кодирования.
5.5.2.2 Процесс декодирования BPGC/CBAC
Процесс декодирования BPGC или декодирования CBAC выполняется на полосах масштабного коэффициента, для которых lazy_bp > 0. Процесс декодирования разрядной матрицы BPGC/CBAC используется, чтобы декодировать символы разрядной матрицы для восстановления целочисленных спектральных данных остатка res. Процесс декодирования разрядной матрицы стартует с max_bp для каждого sfb и постепенно продолжается с нижними разрядными матрицами. Для начала разрядная матрица NUM_BP сканирует символы разрядной матрицы, которые являются арифметически декодированными, как иллюстрировано в следующем псевдокоде:
/* preparing the help element */ for (g=0;g<num_window_groups;g++){ for (sfb = 0;sfb<num_sfb;sfb++){ width = swb_offset[g][sfb+1] — swb_offset[g][sfb]; for (win = 0; win <window_group_len[g];win++) { for (bin=0;bin<width;bin++){
is_sig[g][win][sfb][bin] =
(quant[g][sfb][win][bin])&&(band_type[g][sfb]==ImplicitBand)?1:0;
            /* sign will be determined implicitly if is_sig == 1 */<br>
            amp[g][win][sfb][bin] = 0;<br>
            sign[g][win][sfb][bin] = 1;<br>
        }<br>
    }<br>
    cur_bp[g][sfb] = max_bp[g][sfb];<br>
     }<br>
  }
/* BPGC/CBAC decoding */
while ((max_bp[g][sfb] — cur_bp[g][sfb]<NUM_BP) && (cur_bp[g][sfb] >= 0)){
for (g=0;g<num_window_groups;g++){
for (sfb — 0;sfb<num_sfb;sfb++){
if ((cur_bp[g][sfb]>=0) && (lazy_bp[g][sfb] > 0)){
width = swb_offset[g][sfb+1] — swb_offset[g][sfb];
for (win=0;win<window_group_len[g];win++){
for (bin=0;bin<width;bin++){
if (!is_lle_ics_eof ()){
if (interval[g][win][sfb][bin] >
amp[g][win][sfb][bin] + (1<<cur_bp[g][sfb])
{
                              freq = determine_frequency();
                              sym = decode(freq);
                              amp[g][win][sfb][bin] += sym << cur_bp[g][sfb];
                                 /* decode bit-plane cur_bp */
                              if ((!is_sig[g][win][sfb][bin]) && (sym )) {
                                 /* decode sign bit of res if necessary */
                                 sign[g][win][sfb][bin] = (decode(freq_sign))? -1:1;
                                 is_sig[g][win][sfb][bin] = 1;
                                 }
                             }
                          }
                     else {
                          smart_decoding_cbac_bpgc();
                      }
                  }
              }
              cur_bp[g][sfb]--; /* progress to next bit-plane */
          }
      }
  }
}
После этого BPGC/CBAC вводит режим декодирования lazy после пропуска 2 битов, завершающих строку, где символы разрядной матрицы непосредственно читаются из входного потока битов:
/* BPGC/CBAC lazy decoding / read_bits(1);read_bits(1); / skip the 2 AC termination string before lazy coding while (cur_bp[g][sfb] >= 0){ for (g=0;g<num_window_groups;g++){ for (sfb = 0;sfb<num_sfb+num_osf_sfb;sfb++){ if ((cur_bp[g][sfb]>=0) && (lazy_bp[g][sfb] > 0)){ width = swb_offset[g][sfb+1] — swb_offset[g][sfb]; for (win=0;win<window_group_len[g]; win++){ for (bin=0;bin<width;bin++) {if (!is_lle_ics_eof ()){ if (interval[g][win][sfb][bin] > amp[g][win][sfb][bin] + (1<<cur_bp[g][sfb]) { sym = read_bit(); amp[g][win][sfb][bin] += sym << cur_bp[g][sfb]; /* decode bit-plane cur_bp / if ((!is_sig[g][win][sfb][bin]) && (sym )) { / decode sign bit of res if necessary */ sign[g][win][sfb][bin] = (decode(freq_sign))? -1:1; is_sig[g][win][sfb][bin] = 1; } } } } } cur_bp[g][sfb]--; } } } }
Значение NUM_BP определяется в таблице 19.
| cb cbac | NUM_BP |
|---|---|
| 0 (BPGC) | 4 |
| 1 (CBAC) | 6 |
Частота присвоения вероятности freq в вышеупомянутом процессе декодирования BPGC/CBAC является частотой BPGC freq_bpgc или частотой CBAC freq_cbac в зависимости от того, декодируется ли текущее LLE_ICS с таблицей частот BPGC или CBAC. freq_bpgc определяется отношением cur_bp к параметру lazy_bp, как дано в таблице 20. Биты знака в вышеупомянутом процессе декодирования декодируются с частотой 8192, то есть freq_sign = 8192.
| cur_bp | Частота BPGC |
|---|---|
| lazy_bp+3 | 64 |
| lazy_bp+2 | 964 |
| lazy_bp+1 | 3277 |
| lazy_bp | 5461 |
| <lazy_bp | 8192 |
Значение freq_cbac определяется контекстом символа разрядной матрицы, который в настоящий момент декодируется. Есть три типа контекста, используемого в CBAC.
Контекст 1: полоса частот (fb)
Контекст fb определяется индексом чередующихся спектральных данных остаточного IntMDCT c [i], i = 0,...1024*osf-1 и частотой дискретизации текущего уровня LLE, как показано в следующей таблице 21.
Контекст полосы частот (fb) [элемент разрешения по частоте]
Контекст 2: существенное состояние (ss)
Для чередующихся спектральных данных остаточного IntMDCT c [i], i = 0, ....., 1024* osf-1, которые являются несущественными (символы разрядной матрицы c[i], декодированные до тех пор, пока не являются все нулями), контекст ss определяется значением его смежных спектральных данных:
sig_cx (i, bp) = {sig_state (i — 2,bp),sig_state (i — 1,bp),sig_state (i + 1,bp),sig_state (i + 1,bp)}
где sig_state (i, bp) определяется как
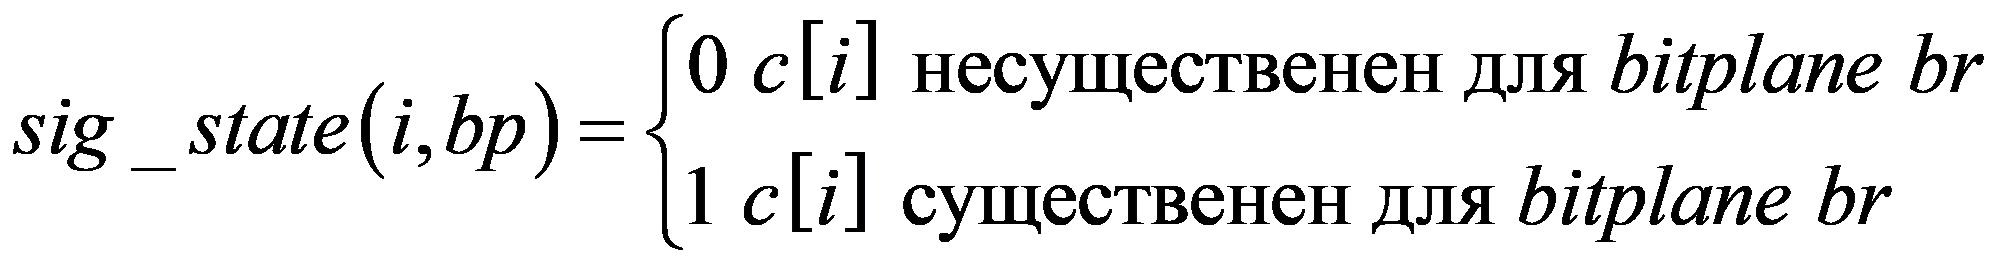
и sig_state (i, bp) определяется как 0, если i меньше 0, или больше длины IntMDCT.
Для c[i], который является существенным, контекст ss определяется типом полосы масштабного коэффициента, которую он формирует:
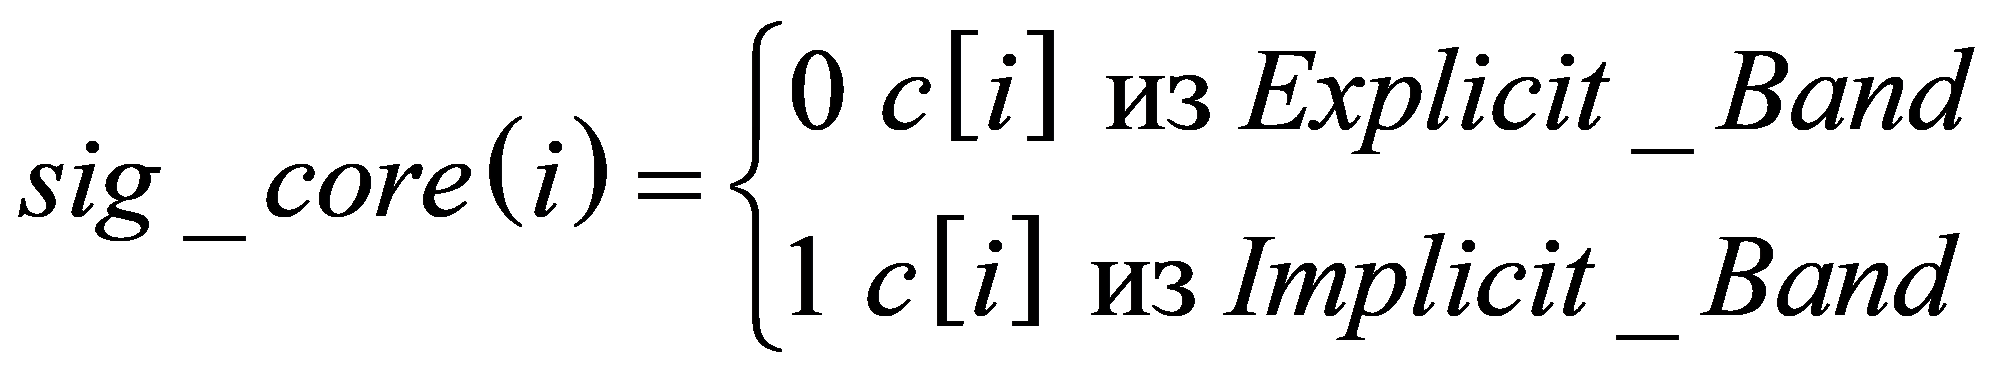
Кроме того, для последнего случая контекст ss далее определяется согласно значению quant_interval (i, bp), установленному как:
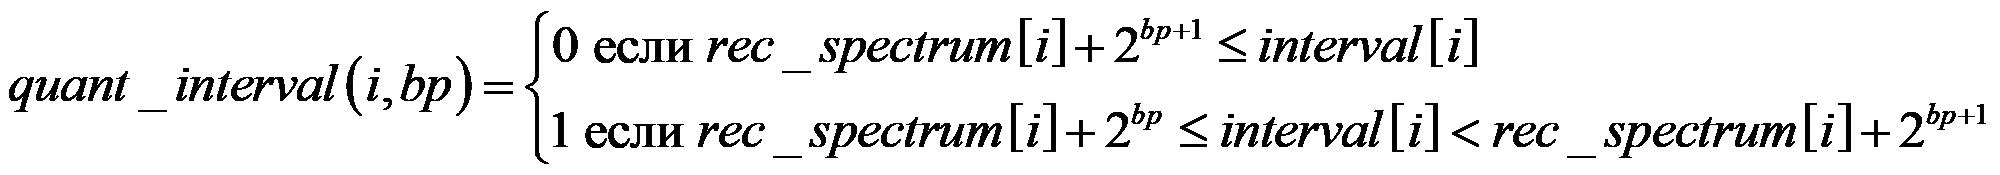
Присвоение контексту ss обобщается в следующей таблице 22.
Контекст состояния значения (ss)
Контекст 3: расстояние до lazy (d2l)
Контекст d2l определяется расстоянием cur_bp до параметра lazy_bp декодируемого в момент символа разрядной матрицы. Подробно назначение перечислено в таблице 23.
Расстояние до контекста lazy (D2L)
| Номер контекста | cur_bp — lazy_bp |
|---|---|
| 0 | < -2 |
| 1 | -2 |
| 2 | -1 |
| 3 | 0 |
| 4 | 1 |
| 5 | 2 |
| 6 | 3 |
Частоты freq_cbac для каждого контекста даются в таблице 24.
5.5.2.3 Декодирование кода низкоэнергетического режима (LEMC)
Следующий псевдокод иллюстрирует процесс декодирования LEMC, который выполняется на полосах масштабного коэффициента, для которых lazy_bp <= 0.
/* low energy mode decoding / for (g = 0;g < num_window_groups; g++){ for (sfb = 0; sfb <num_sfb+num_osf_sfb;sfb++){ if ((cur_bp[g][sfb] >= 0) && (lazy_bp[g][sfb] <= 0)) { width = swb_offset[g][sfb+1] — swb_offset[g][sfb]; for (win=0;win<window_group_len[g];win++){ for (bin=0;bin<width;bin++){ res[g][sfb][win][bin] = 0; pos = 0; / decoding of binary string and reconstructing res / while (1) { if (is_lle_ics_eof())smart_decoding_low_energy(pos, res[g][sfb][win][bin]); if(decode(freq_silence[pos])==0) break; res[g][sfb][win][bin] ++; pos++; if(pos>2) pos = 2; if(res[g][sfb][win][bin]==(1<<(max_bp[g][sfb]+1))-1) break; } / decoding of sign of res */ if (!is_sig[g][win][sfb][bin]) && res[g][sfb][win][bin]){ res[g][sfb][win][bin] *= (decode(freq_sign))?-1:1; is_sig[g][win][sfb][bin] = 1; } } } } } }
Присвоения вероятности для декодирования низкоэнергетического режима, freq_bpgc и freq_silence даются в таблице 25. Биты знака в вышеупомянутом процессе декодирования декодируются с частотой 8192, то есть freq_sign = 8192.
 |
0 | -1 | -2 | -3 |
|---|---|---|---|---|
| 0 | 12603 | 9638 | 6554 | 3810 |
| 1 | 7447 | 3344 | 1820 | X |
| > 1 | 6302 | 745 | 552 | X |
Таблица 26 определяет отображение между двоичной строкой, декодируемой в случае низкоэнергетического режима и остаточными спектральными данными res. Бит знака res декодируется после того, как декодировался первый ненулевой символ разрядной матрицы.
Преобразование res в двоичную форму в режиме низкоэнергетического кодирования
5.5.2.4 Арифметическое декодирование
Следующий псевдокод иллюстрирует процесс целочисленного арифметического декодирования, используемый в BPGC/CBAC и процессе декодирования низкоэнергетического режима.
#define CODE_WL 16 #define PRE_SHT 14 #define TOP_VALUE (((long)1<<CODE_WL)-1) #define QTR_VALUE (TOP_VALUE/4+1) #define HALF_VALUE (2QTR_VALUE) #define TRDQTR_VALUE (3QTR_VALUE)
int decode(int freq) { range = (long)((high-low)+1); cumu = ((long)((value-low)+1)<<PRE_SHT); if (cumu<rangefreq) { sym = 1; high = low + (rangefreq<<PRE_SHT)-1; } else { sym = 0; low=low + (rangefreq<<PRE_SHT); } for (;;) { if (high<HALF_VALUE) { } else if (low>=HALF_VALUE) { value -= HALF_VALUE; low -= HALF_VALUE; high -= HALF_VALUE; } else if (low>=QTR_VALUE && high<TRDQTR_VALUE) { value -= QTR_VALUE; low -= QTR_VALUE; high -= QTR_VALUE; } else break; low = 2low; high = 2high+1; value = 2value + read_bits(1); /* input next bit from bit-stream */ } return sym; }
5.5.2.5 Интеллектуальное арифметическое декодирование усеченных потоков битов SLS
Интеллектуальное арифметическое декодирование обеспечивает эффективный способ декодирования промежуточного уровня, соответствующий данной целевой скорости передачи. Этот алгоритм использует тот факт, что буфер декодирования все еще содержит значимую информацию для арифметического декодирования, даже если не остается битов для подачи в буфер декодирования. Процесс декодирования продолжается, пока существует некоторая неоднозначность в определении символа.
Следующий псевдокод иллюстрирует алгоритм обнаружения неоднозначности в модуле арифметического декодирования. Переменная num_dummy_bits представляет число вызовов функции read_bits (1) в процессе арифметического декодирования сразу после точки усечения.
int ambiguity_check(int freq) {
      /* if there is no ambiguity, returns 1    */
      /* otherwise, returns 0                    */
  upper = 1<< num_dummy_bits;
  decisionVal = ((high-low)*freq>>PRE_SHT)-value+low-1;
  if(decisionVal>upper || decisionVal<0) return 0;
  else return 1;
}
Когда num_dummy_bits больше 0, выполняется smart_decoding_cbac_bpgc () или smart_decoding_low_energy (). Чтобы предотвратить ошибки знакового бита, спектральное значение текущей линии спектра должно быть обнулено, когда может произойти неоднозначность при декодировании знакового бита. Все индексные переменные в интеллектуальном процессе декодирования должны быть перенесены из предыдущего процесса арифметического декодирования.
smart_decoding_cbac_bpgc() { /* BPGC/CBAC normal decoding with ambiguity detection */ while ((max_bp[g][sfb] — cur_bp[g][sfb]<LAZY_BP) && (cur_bp[g][sfb] >= 0)){ for (;g<num_window_groups;g++){ for (;sfb<num_sfb;sfb++){ if ((cur_bp[g][sfb]>=0) && (lazy_bp[g][sfb] > 0)){ width = swb_offset[g][sfb+1] — swb_offset[g][sfb]; for (;win < window_group_len[g];win++){ for (;bin<width;bin++){ if (interval[g][win][sfb][bin] > amp[g][win][sfb][bin] + (1<<cur_bp[g][sfb]) { freq = determine_frequency(); if (ambiguity_check(freq)) { / no ambiguity for arithmetic decoding / sym = decode(freq); amp[g][win][sfb][bin] += sym << cur_bp[g][sfb]; */decode bit-plane cur_bp / if ((!is_sig[g][win][sfb][bin]) && (sym)) { / decode sign bit of res if necessary / if (ambiguity_check(freq)) { sym = decode(freq); sign[g][win][sfb][bin] = (sym) ? -1:1; is_sig[g][win][sfb][bin] = 1; } else { / discard the decoded symbol prior to sign symbol / amp[g][win][sfb][bin] = 0; terminate_decoding(); } } } else terminate_decoding(); } } } cur_bp[g][sfb] -- ; / progress to next bit-plane / } } } } } smart_decoding_low_energy(int posPrev, int resPrev) { / low energy mode decoding / for (;g < num_window_groups; g++){ for (; sfb <num_sfb+num_osf_sfb;sfb++){ if ((cur_bp[g][sfb] >= 0) && (lazy_bp[g][sfb] <= 0)) { width = swb_offset[g][sfb+1] — swb_offset[g][sfb]; for (;win<window_group_len[g];win++){ for (;bin<width;bin++){ / Continue to decode after the end of LLE_ICS is reached / res[g][sfb][win][bin] = resPrev; resPrev = 0; pos = posPrev; posPrev = 0; while (1) { / if ambiguity check is false, discard the spectrum is set to be 0 / if(!ambiguity_check(freq)) res[g][sfb][win][bin] = 0, terminate_decoding(); tmp = decode(freq_silence[pos]); if(tmp==0) break; res[g][sfb][win][bin] ++; pos++; if (pos>2) pos = 2; if (res[g][sfb][win][bin]==(1<<(max_bp[g][sfb]+1))-1) break; } / decoding of sign of res / if (!is_sig[g][win][sfb][bin]) && res[g][sfb][win][bin]){ / if ambiguity check is false, the current spectrum value is set to be 0 */ if(!ambiguity_check(freq)) res[g][sfb][win][bin] = 0, terminate_decoding(); res[g][sfb][win][bin] *= (decode(freq_sign)) ?-1:1; is_sig[g][win][sfb][bin] = 1; } } } } } } }
5.6 Компенсация для остатка IntMDCT для раннего завершения декодирования BPGC/CBAC
Если процесс декодирования BPGC/CBAC завершается рано из-за усечения LLE_ICS, res компенсируется элементом res_fill следующим образом:
for (g=0;g<num_window_groups;g++){ for (sfb = 0;sfb<num_sfb+num_osf_sfb;sfb++){ width = swb_offset[g][sfb+1] — swb_offset[g][sfb]; for (win=0; win<window_group_len[g]; win++){ for (bin=0;bin<width;bin++){ if (is_sig[g][win][sfb][bin]){ if (res[g][win][sfb][bin] >= 0) res[g][win][sfb][bin] += (res_fill >> (23-stop_bp[g][win][sfb][bin])); else if (res[g][win][sfb][bin] < 0) res[g][win][sfb][bin] -= (res_fill >> (23-stop_bp[g][win][sfb][bin])); } } } } }
Здесь stop_bp[g][win][sfb][bin] является наивысшей разрядной матрицей, для которой символ разрядной матрицы не декодируется из-за раннего завершения LLE_ICS. Значение res_fill дается в таблице 27.
| stop_bp | res_fill |
|---|---|
| lazy_bp+3 | 1572608 |
| lazy_bp+2 | 3079935 |
| lazy_bp+1 | 5172975 |
| lazy_bp | 6990507 |
| <lazy_bp | 8388607 |
5.7 Инверсное отображение ошибки
5.7.1 Принцип
Процесс инверсного отображения ошибки используется, чтобы восстановить спектральные данные IntMDCT из остаточных данных IntMDCT из уровня LLE и квантованных спектральных данных MDCT из базового уровня. Этот процесс применяется только в диапазоне непередискретизации. Ввод в инструмент инверсного отображения ошибки является амплитудой amp и знаком sign спектральных данных остатка res и квантованных спектральных данных quant. Его выводом являются восстановленные спектральные данные IntMDCT c. Процедура инверсного отображения ошибки описывается следующим образом:
res[g][win][sfb][bin]= sign[g][win][sfb][bin] amp[g][win][sfb][bin];* if (quant[g][win][sfb][bin]==0) c[g][win][sfb][bin]=res[g][win][sfb][bin]; else *c[g][win][sfb][bin] = sign(quant[g][win][sfb][bin]) ** (res[g][win][sfb][bin]+ref(quant[g][win][sfb][bin]);
Чтобы гарантировать кодирование без потерь, в кодере SLS должна использоваться следующая процедура отображения ошибки для того же самого спектра частот:
if (quant[g][win][sfb][bin]==0)
res[g][win][sfb][bin]=c[g][win][sfb][bin];
res[g][win][sfb][bin]=sign(quant[g][win][sfb][bin]) c[g][win][sfb][bin]-*
Функция ref(x) в вышеприведенном процессе детерминированно вычисляется следующим образом
if ((sfb is Implicit_Band) then
else if (sfb is Explicit_Band)
Здесь вычисление thr() и inv_quan () следует 5.4.2.3.
5.8 Целочисленный процесс Mid/Side
Если для левого и правого каналов используется Mono IntMDCT (common_window = = 0 или use_stereo_intmdct = = 0), к полосам масштабного коэффициента должна быть применена инверсная целочисленная обработка M/S, где флаг M/S включен.
Декодирование Mid/Side (M/S) выполняется на целочисленных спектральных значениях, используя схему подъема следующим образом:
где M, S, R, L обозначает спектральные данные каналов Mid, Side, Left и Right, а также
c_{1} = (cos \frac{\pi}{2} - 1)/sin \frac{\pi}{2} и c_{2} = sin \frac{\pi}{4} .
Инверсный Stereo IntMDCT ожидает спектр M/S по умолчанию. Следовательно M/S должно быть применено к полосам масштабного коэффициента там, где флаг M/S выключается.
Кодирование Mid/Side (M/S) выполняется на целочисленных спектральных значениях, используя схему подъема следующим образом:
где M, S, L, R обозначают спектральные данные каналов Mid, Side, Left, и Right и
c_{1} = (cos \frac{\pi}{2} - 1)/sin \frac{\pi}{2} и c_{2} = sin \frac{\pi}{4} .
5.9 Целочисленное формирование временного шума (IntTNS)
Когда в ядре AAC используется формирование временного шума (TNS), тот же самый фильтр TNS применяется к целочисленным спектральным значениям в SLS. Чтобы преобразовать этот фильтр в детерминированный обратимый целочисленный фильтр, требуются следующее:
Для того, чтобы определить коэффициенты LPC, используется функция int_tns_decode_coef (), как описано в следующем псевдокоде:
define SHIFT_INTTNS 21 INT32 tnsInvQuantCoefFixedPoint(coef_res, coef) { INT32 intTnsCoef_res3[8] = {-2065292, -1816187, -1348023, -717268, 0, 909920, 1639620, 2044572}; INT32 intTnsCoef_res4[16] = {-2088206, -2017095, -1877294, -1673563, -1412842, -1104008, -757579, -385351, 0, 436022, 852989, 1232675, 1558488, 1816187, 1994510, 2085664}; if (coef_res == 3) { return intTnsCoef_res3[4+coef]; } if (coef_res == 4) { return intTnsCoef_res4[8+coef]; } } / Decoder transmitted coefficients for one TNS filter / *int_tns_decode_coef(order, coef_res, coef, INT32 a) { INT32 tmp[TNS_MAX_ORDER+1], b[TNS_MAX_ORDER+1]; / Inverse quantization / for (i=0; i<order; i++) { tmp[i+1]=tnsInvQuantCoefFixedPoint(coef_res, coef[i]); } / Conversion to LPC coefficients / / worst case for order == 12 and all coefficients == 1: *6th coefficient raised by 12!/(6!6!) = 924 *-> 10 bits headroom required -> SHIFT_INTTNS == 21 / a[0] = 1<<SHIFT_INTTNS; for (m=1; m<=order; m++) { b[0] = a[0]; for (i=1; i<m; i++) { *b[i] = a[i] + ((((((INT64)tmp[m])a[m-i])>>(SHIFT_INTTNS-1))+1)>>1); } b[m] = tmp[m]; for (i=0; i<=m; i++) { a[i] = b[i]; } } }
*Основанная на получающихся коэффициентах LPC с фиксированной точкой детерминированная целочисленная версия фильтра TNS применяется к целочисленному спектру в декодере. Это делается путем замены функции tns_ar_filter () функцией int_tns_ar_filter (), описываемой следующим псевдокодом: int_tns_ar_filter(INT32 *spec, size, inc, INT32 lpc, order)
{ INT32 y, state[TNS_MAX_ORDER]; INT64 temp_accu; for (i=0; i<order; i++) state[i] = 0; if (inc == -1) spec += size-1; for (i=0; i<size; i++) { *y = spec; temp_accu = 0; for (j=0; j<order; j++) { temp_accu += ((INT64)lpc[j+1]) * state[j]; } y -= (INT32)(((temp_accu >> (SHIFT_INTTNS-1)) + 1) >> 1 ); for (j=order-1; j>0; j-) state[j] = state[j-1]; state[0] = y; *spec = y; spec += inc; } }
Если используется StereoIntMDCT, вместо спектра L/R целочисленные спектральные значения представляют спектр M/S. В этом случае перед IntTNS должно быть применено инверсное целочисленное M/S, а после должно быть применено прямое целочисленное M/S.
Чтобы гарантировать реконструкцию без потерь, в кодере должен быть применен к целочисленному спектру соответствующий прямой прогноз LPC. Это достигается применением к целочисленному спектру функции int_tns_decode_coef() и соответствующего прямого фильтра, как описано в следующем псевдокоде:
int_tns_filter_encode(length, order, direction, INT32 spec, INT32 lpc) { INT64 temp_accu; if (direction) { / Startup, initial state is zero / temp[length-1]=spec[length-1]; for (i=length-2;i>(length-1-order);i --) { temp[i]=spec[i]; temp_accu = 0; k++; for (j=1;j<=k;j++) { temp_accu += ((INT64)temp[i+j]) * a[j]; } spec[i] += (INT32)(((temp_accu >> (SHIFT_INTTNS-1)) + 1) >> 1); } / Now filter the rest / for (i=length-1-order;i>=0;i --) { temp[i]=spec[i]; temp_accu = 0; for (j=1;j<=order;j++) { temp_accu += ((INT64)temp[i+j]) * a[j]; } spec[i] += (INT32)(((temp_accu >> (SHIFT_INTTNS-1)) + 1) >> 1 ); } } else { / Startup, initial state is zero / temp[0]=spec[0]; for (i=1;i<order;i++) { temp[i]=spec[i]; temp_accu = 0; for (j=1;j<=i;j++) { temp_accu += ((INT64)temp[i-j]) * a[j]; } spec[i] += (INT32)(((temp_accu >> (SHIFT_INTTNS-1)) +1) >> 1 ); } / Now filter the rest / for (i=order;i<length;i++) { temp[i]=spec[i]; temp_accu = 0; for (j=1;j<=order;j++) { *temp_accu += ((INT64)temp[i-j])a[j]; } spec[i] += (INT32)(((temp_accu >> (SHIFT_INTTNS-1)) + 1) >> 1 ); } } }
В случае, если используется StereoIntMDCT, целочисленные спектральные значения представляют спектр M/S вместо спектра L/R. В этом случае инверсное целочисленное M/S должно быть применено перед IntTNS и прямое целочисленное M/S должно быть применено после.
5.10 IntMDCT и инверсное IntMDCT
5.10.1 Описание
IntMDCT является обратимым целочисленным приближением MDCT. Следующий раздел описывает структурную реализацию MDCT и IMDCT, используемую для прямого и инверсного IntMDCT.
В дальнейшем длина фрейма № всегда обозначает число новых входных выборок в каждом блоке, которое равно числу значений частоты, таким образом № является osf 1024 или osf* 128.*
5.10.2 MDCT и инверсный MDCT (IMDCT)
X(m) = \sqrt{\frac{2}{N}} \sum_{k = 0}^{2N - 1} \omega(k)x(k)cos \frac{(2k + 1 + N)(2m + 1)\pi}{4N} , где m = 0,....., N — 1
N: Длина фрейма (osf 1024 или osf* 128)*
\omega(k) : Функция окна (Sine или KBD)
x(k) = \omega(k) \sqrt{\frac{2}{N}} \sum_{m = 0}^{N - 1} x(m)cos \frac{(2k + 1 + N)(2m + 1)\pi}{4N} , где k = 0,....., 2N — 1
Вход в MDCT и выход из IMDCT имеют 50% перекрытие, то есть № выборок. В IMDCT вывод двух последующих блоков добавляется в области перекрытия.
5.10.2.1 MDCT и IMDCT посредством DCT-IV
MDCT и IMDCT для IntMDCT делятся на два блока:
работа с окнами (Windowing) и искажение временного домена (TDA);
дискретное косинусное преобразование типа IV (DCT-IV).
5.10.2.2 Вычисление и работа с окнами блока TDA
5.10.2.3 Структура MDCT и IMDCT для различных последовательностей окон
В MDCT блок Windowing (работа с окнами) блока TDA вычисляется согласно
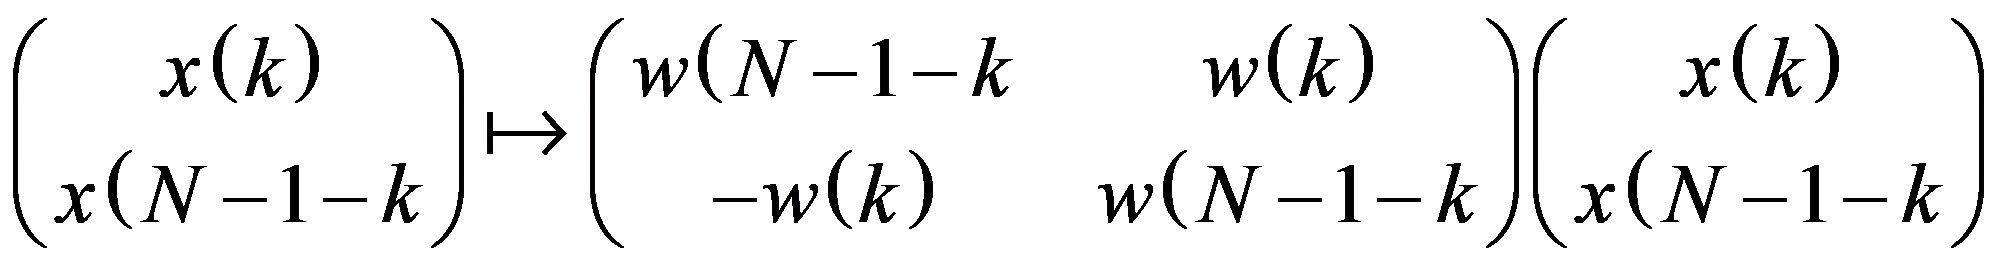 , где k = 0,....., N/2 — 1.
В IMDCT этот блок инвертируется согласно
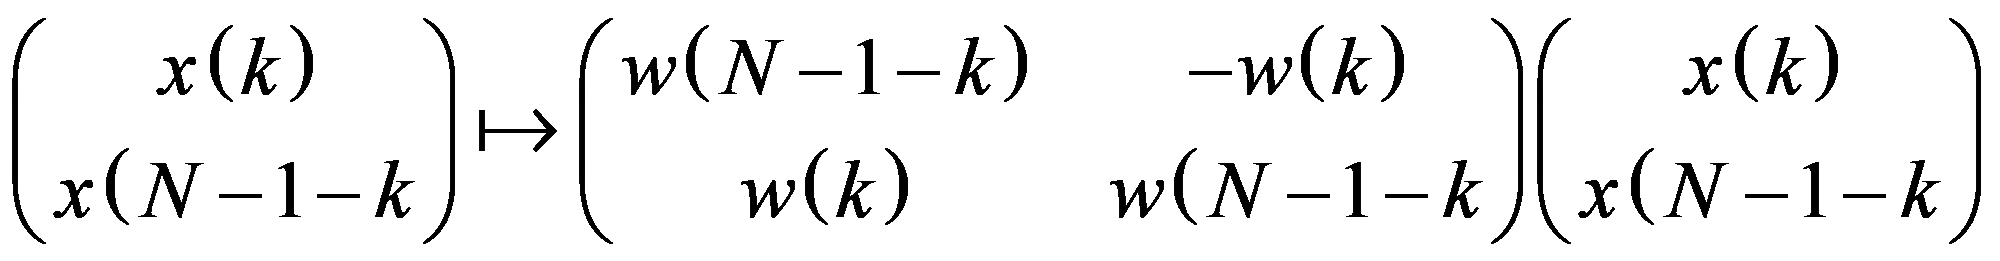 , где k = 0,....., N/2 — 1.
Операция наложения/добавления уже содержится в этом вычислении.
DCT-IV длины № определяется так:
x(m) = \sqrt{\frac{2}{N}} \sum_{k = 0}^{N - 1} x(k)cos \frac{(2k + 1)(2m + 1)\pi}{4N} , где m = 0,....., N — 1
Инверсный DCT-IV длины № имеет те же самые коэффициенты, это определяется как:
x(k) = \sqrt{\frac{2}{N}} \sum_{m = 0}^{N - 1} x(m)cos \frac{(2k + 1)(2m + 1)\pi}{4N} , где k = 0,....., N — 1
Для вычисления MDCT рассматривают вывод двух последующих этапов Windowing/TDA. Пусть x'(0),... x'(N — 1) будет выводом этапа Windowing/TDA предыдущего блока и x'(N),....., x'(2N — 1) будет выводом этапа Windowing/TDA текущего блока. Затем DCT-IV применяется к значениям N
- x'(N + N/2 — 1), — x'(N + N/2 — 2),....., — x'(N), — x'(N — 1), — x'(N — 2),....., — x'(N/2).
То есть используются вторая половина предыдущего блока и первая половина текущего блока. Порядок значений возвращается, и значения умножаются на -1 прежде, чем применить DCT-IV длины N.
Вторая половина текущего блока выходных значений Windowing/TDA должна быть сохранена для следующего блока.
Для вычисления IMDCT спектральные значения MDCT преобразовываются инверсным DCT-IV, вывод умножается на -1, и порядок инвертируется. Затем вторая половина сохраняется для следующего блока, первая половина обрабатывается инверсным блоком Windowing/TDA вместе со значениями, сохраненными из предыдущего блока.
5.10.2.4 Структура MDCT и IMDCT для различных последовательностей окон
На рисунке 1 и 2 структура иллюстрируется для типичных последовательностей окон.
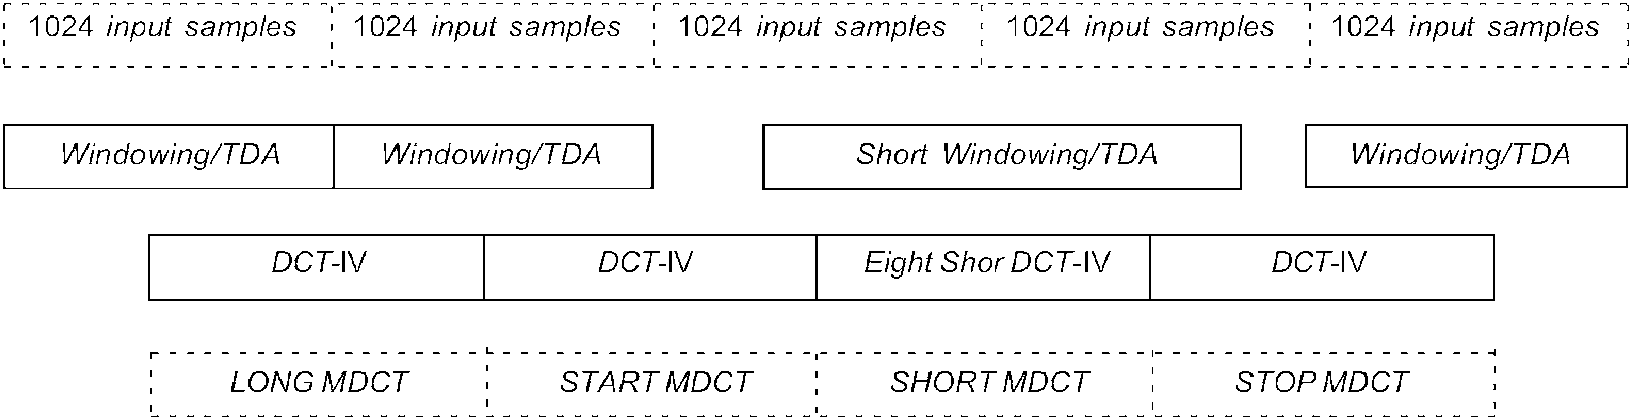
Рис. 1 — Структура MDCT для последовательности LONG, START, SHORT, STOP
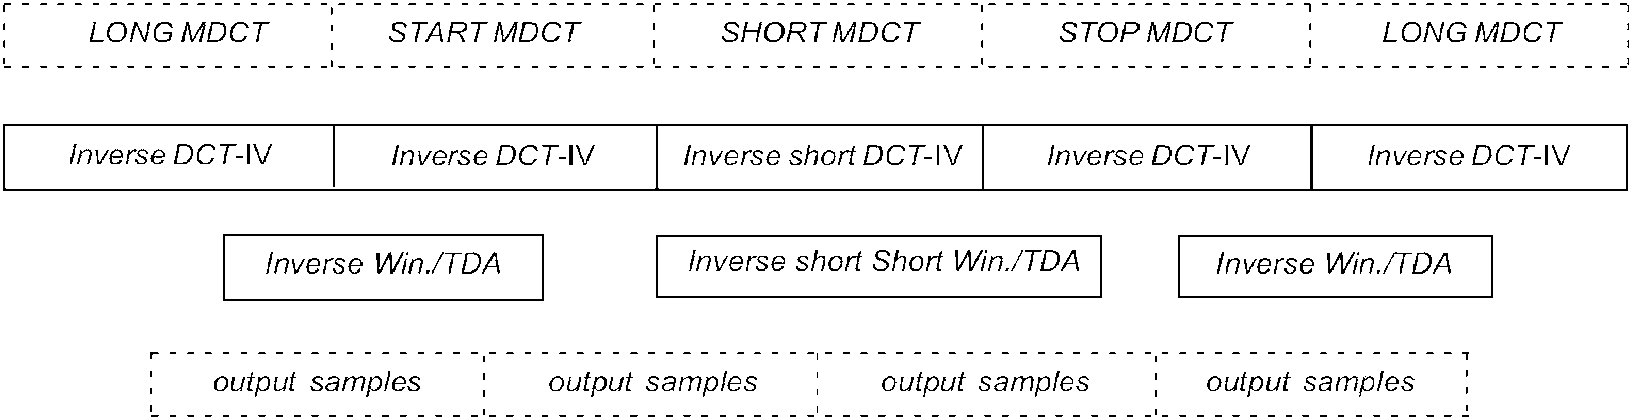
Рис. 2 — Структура IMDCT для последовательности LONG, START, SHORT, STOP, LONG
5.10.2.5 IntMDCT
IntMDCT является инверсным целочисленным приближением MDCT. Здесь используются две версии этого преобразования, полагаясь на тот же самый алгоритм:
Mono-IntMDCT: Эта версия обеспечивает спектр IntMDCT одного канала.
Stereo-IntMDCT: В случае элемента пары каналов с включенными common_window и use_stereo_intmdct, используется эта версия. Она обеспечивает спектр Mid/Side IntMDCT левого и правого каналов одновременно.
Разложение MDCT на шаги подъема
Для IntMDCT все вычисления разлагаются на так называемые шаги подъема, позволяя вводить операцию округления, не теряя свойство совершенной реконструкции.
В прямом IntMDCT блок Windowing/TDA вычисляется по 3N/2 шагам подъема:
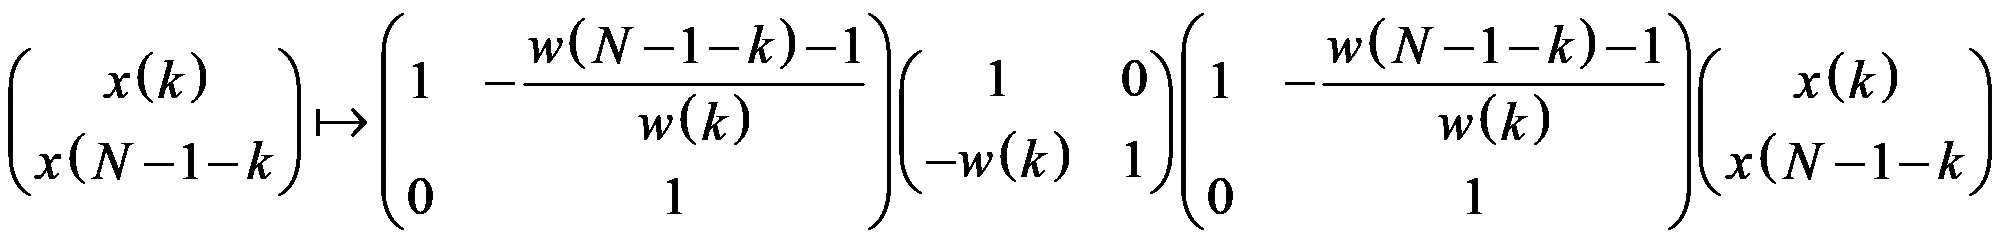 ,
В инверсном IntMDCT блок Windowing/TDA вычисляется согласно:
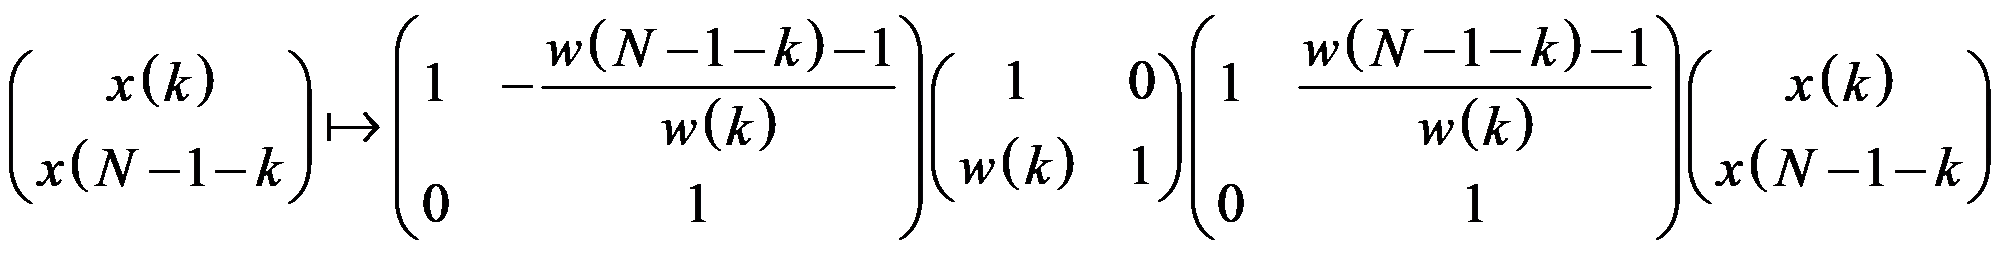 ,
Эти вычисления математически эквивалентны вычислению, описанному выше, потому что функция окна w (k) выполняет условие TDAC w(k)2 + w(N — 1 - k)2 = 1, k = 0, N/2 — 1.
После каждого шага подъема применяется операция округления, чтобы остаться в целочисленном домене.
Для IntMDCT DCT-IV вычисляется обратимым целочисленным способом, названным Int-DCT-IV. Int-DCT-IV длины № реализуется так называемыми многомерными шагами подъема. У них имеется следующая общая структура:
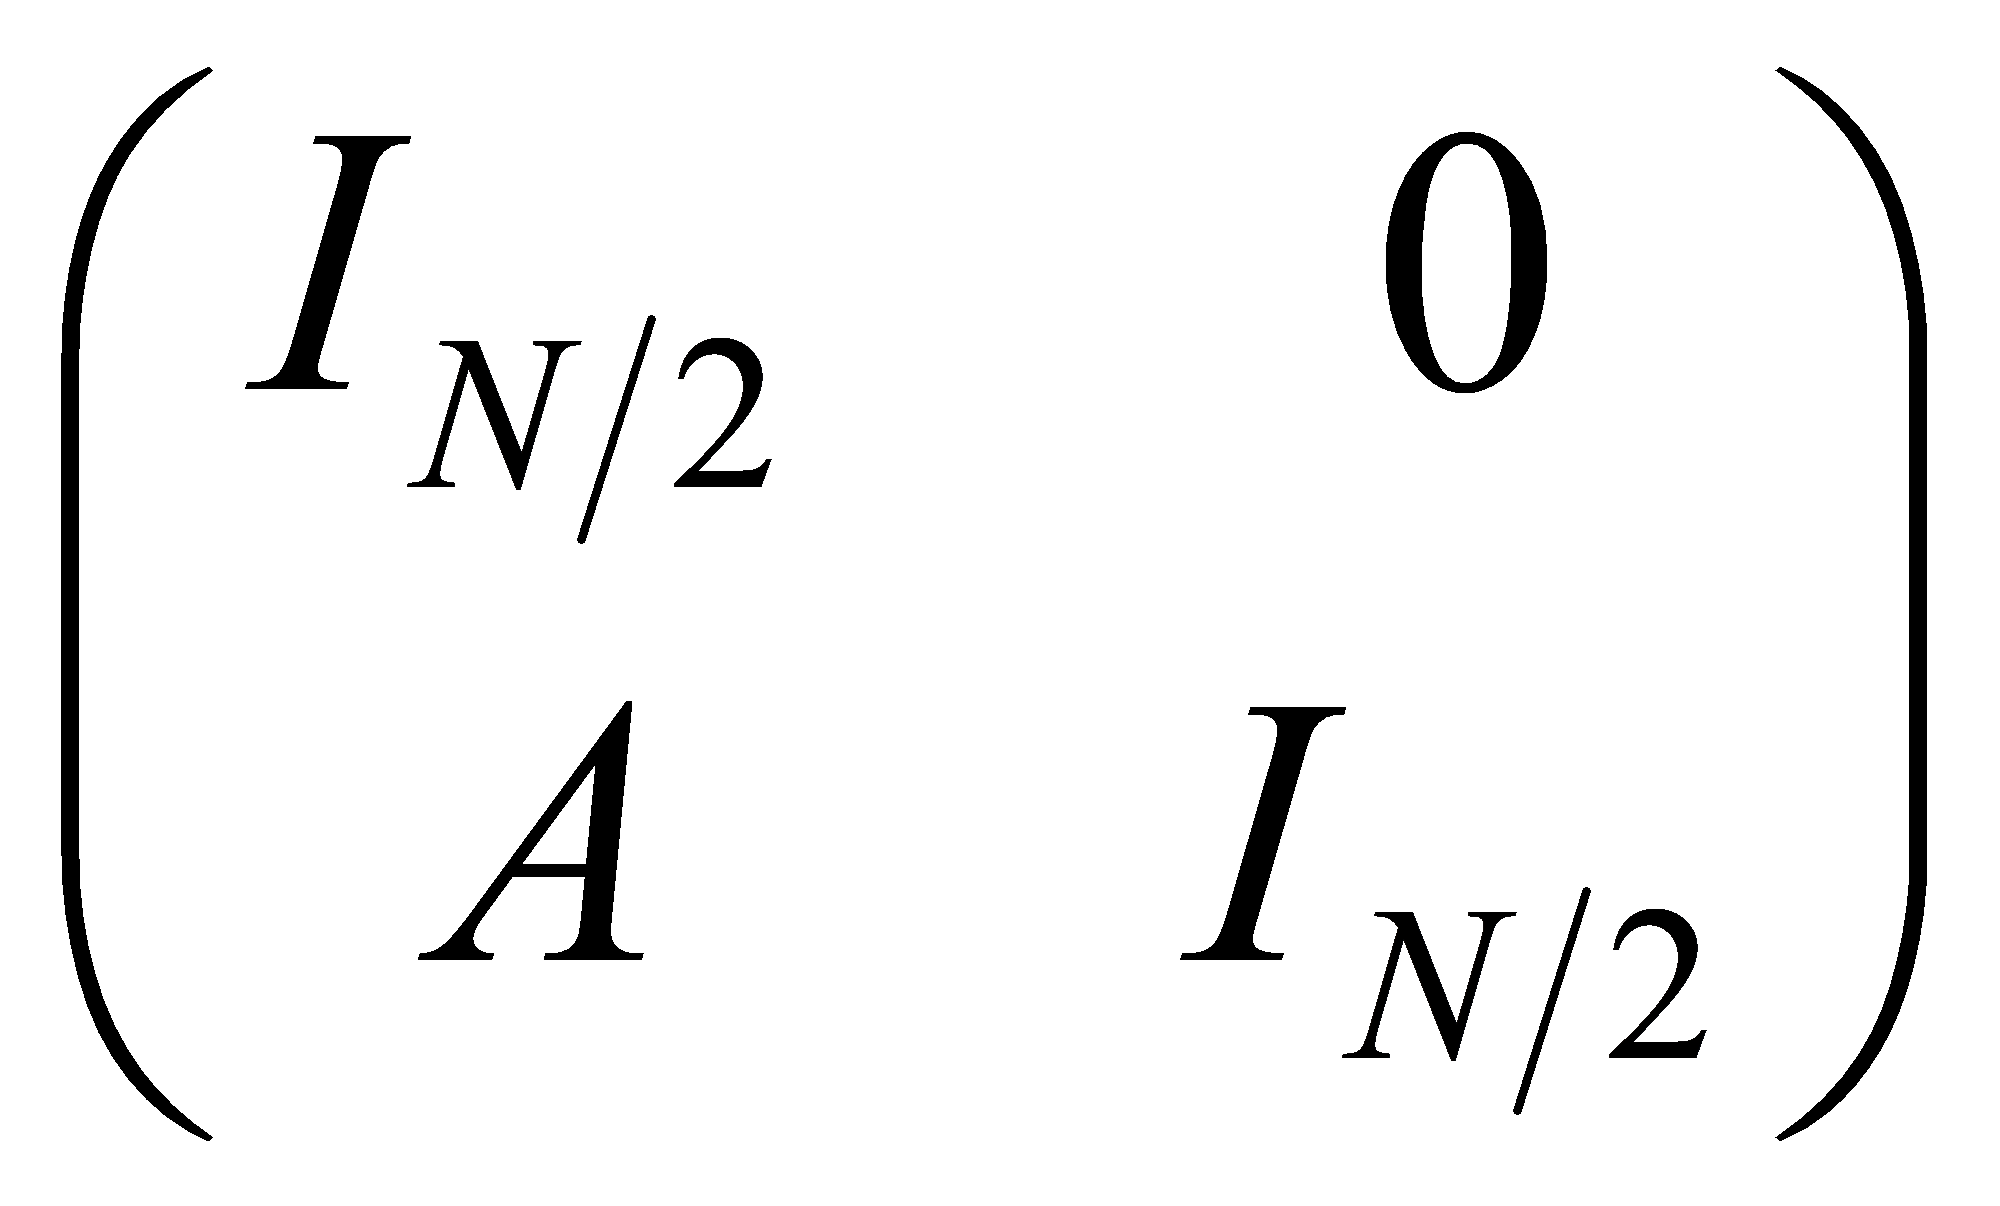
с матрицей идентичности IN/2 размера N/2 и произвольной A матрицей (N/2)x(N/2).
Применение этой блочной матрицы означает, что первая половина входных значений обрабатывается матрицей A и затем добавляется ко второй половине входных значений.
Для целочисленного приближения выходные значения матрицы A, прежде чем их добавить, округляются до целого числа.
Этот процесс может быть инвертирован с помощью
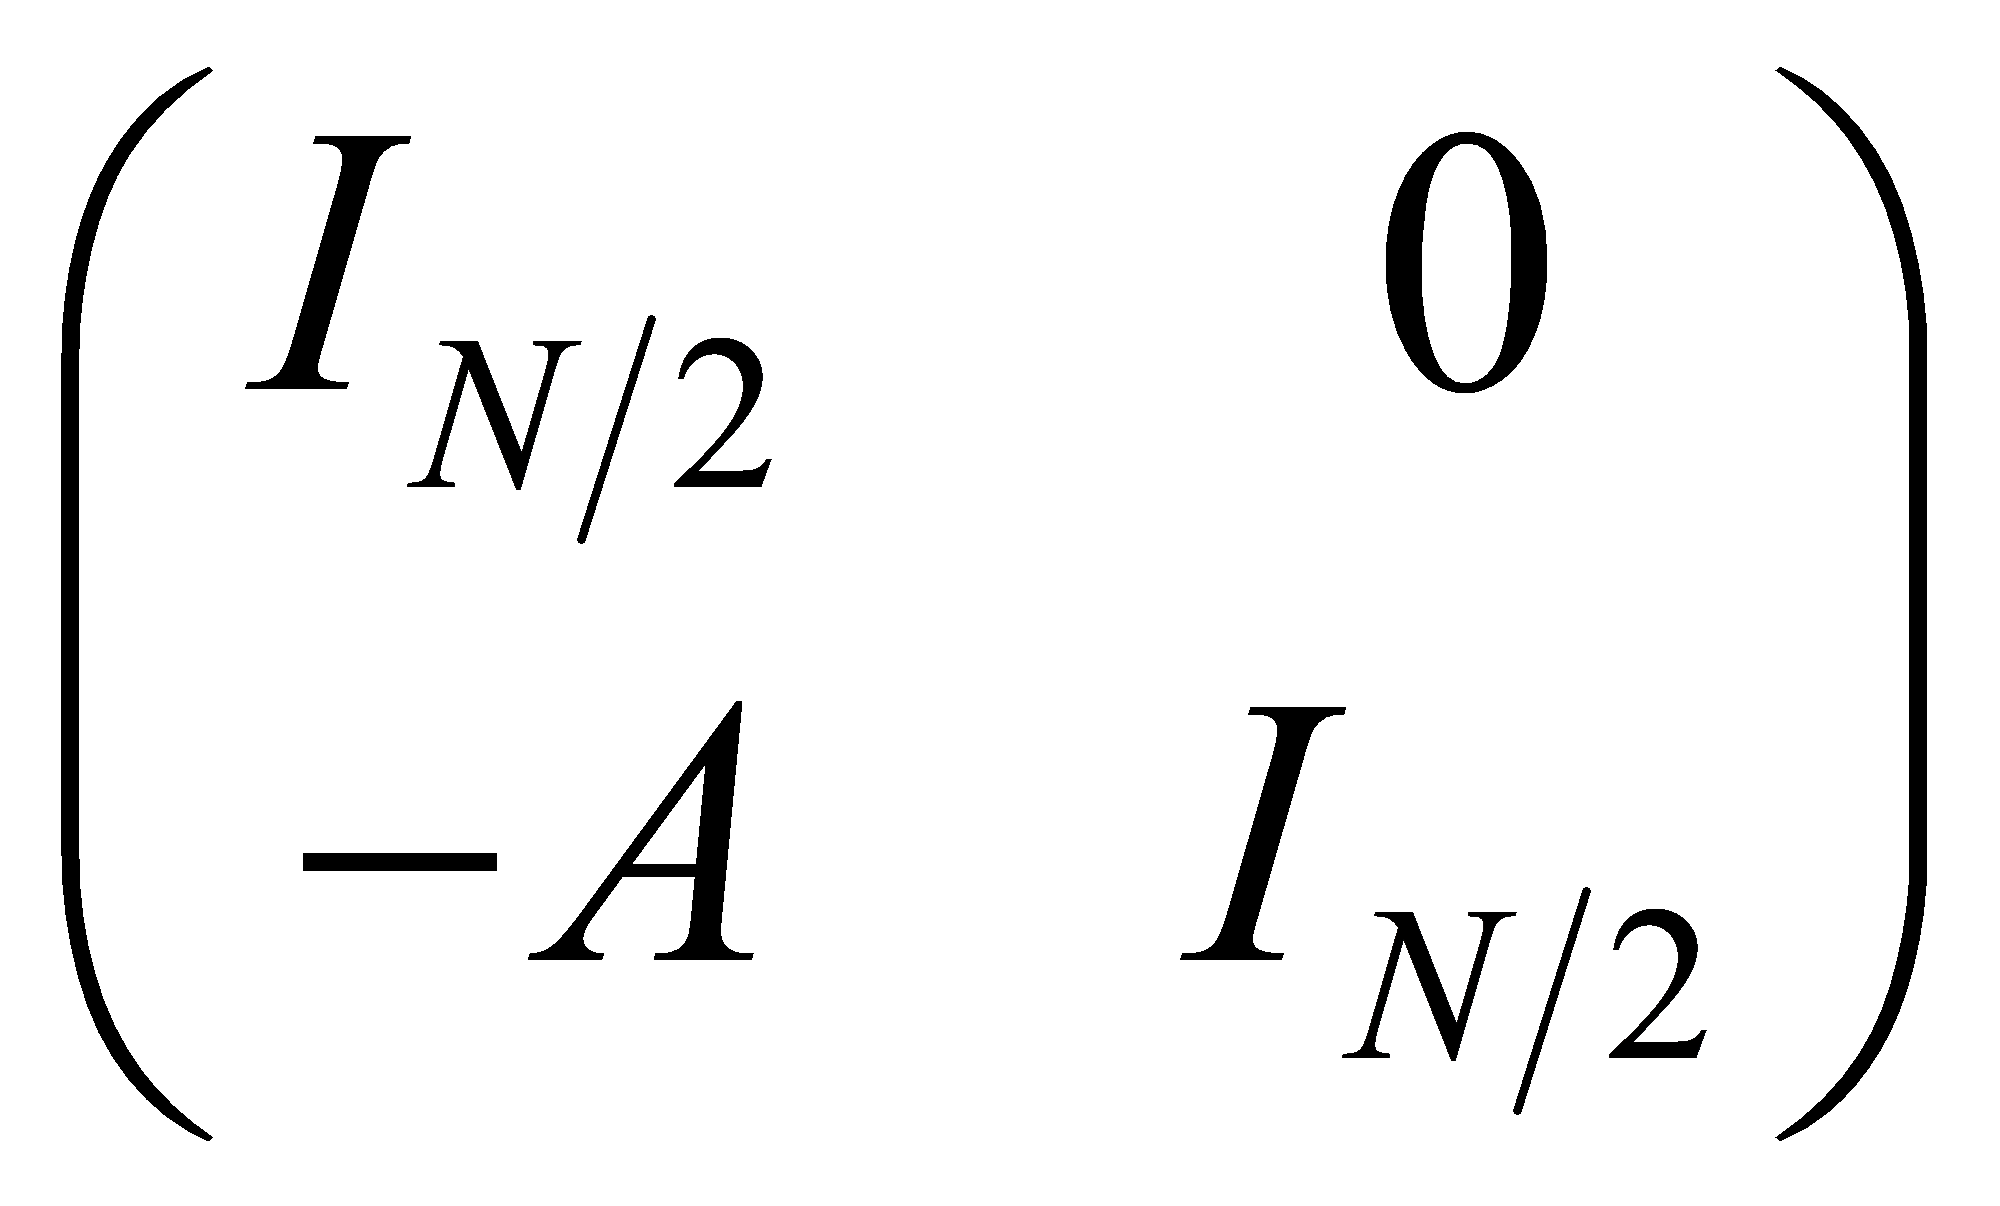 .
То есть та же самая матрица A применяется к первой половине значений, и получающиеся значения вычитаются из второй половины входных значений.
Для обратимого целочисленного приближения выходные значения A округляются до целого числа прежде, чем вычесть их.
Чтобы применить эту структуру к IntMDCT, DCT-IV длины № разлагается следующим образом:
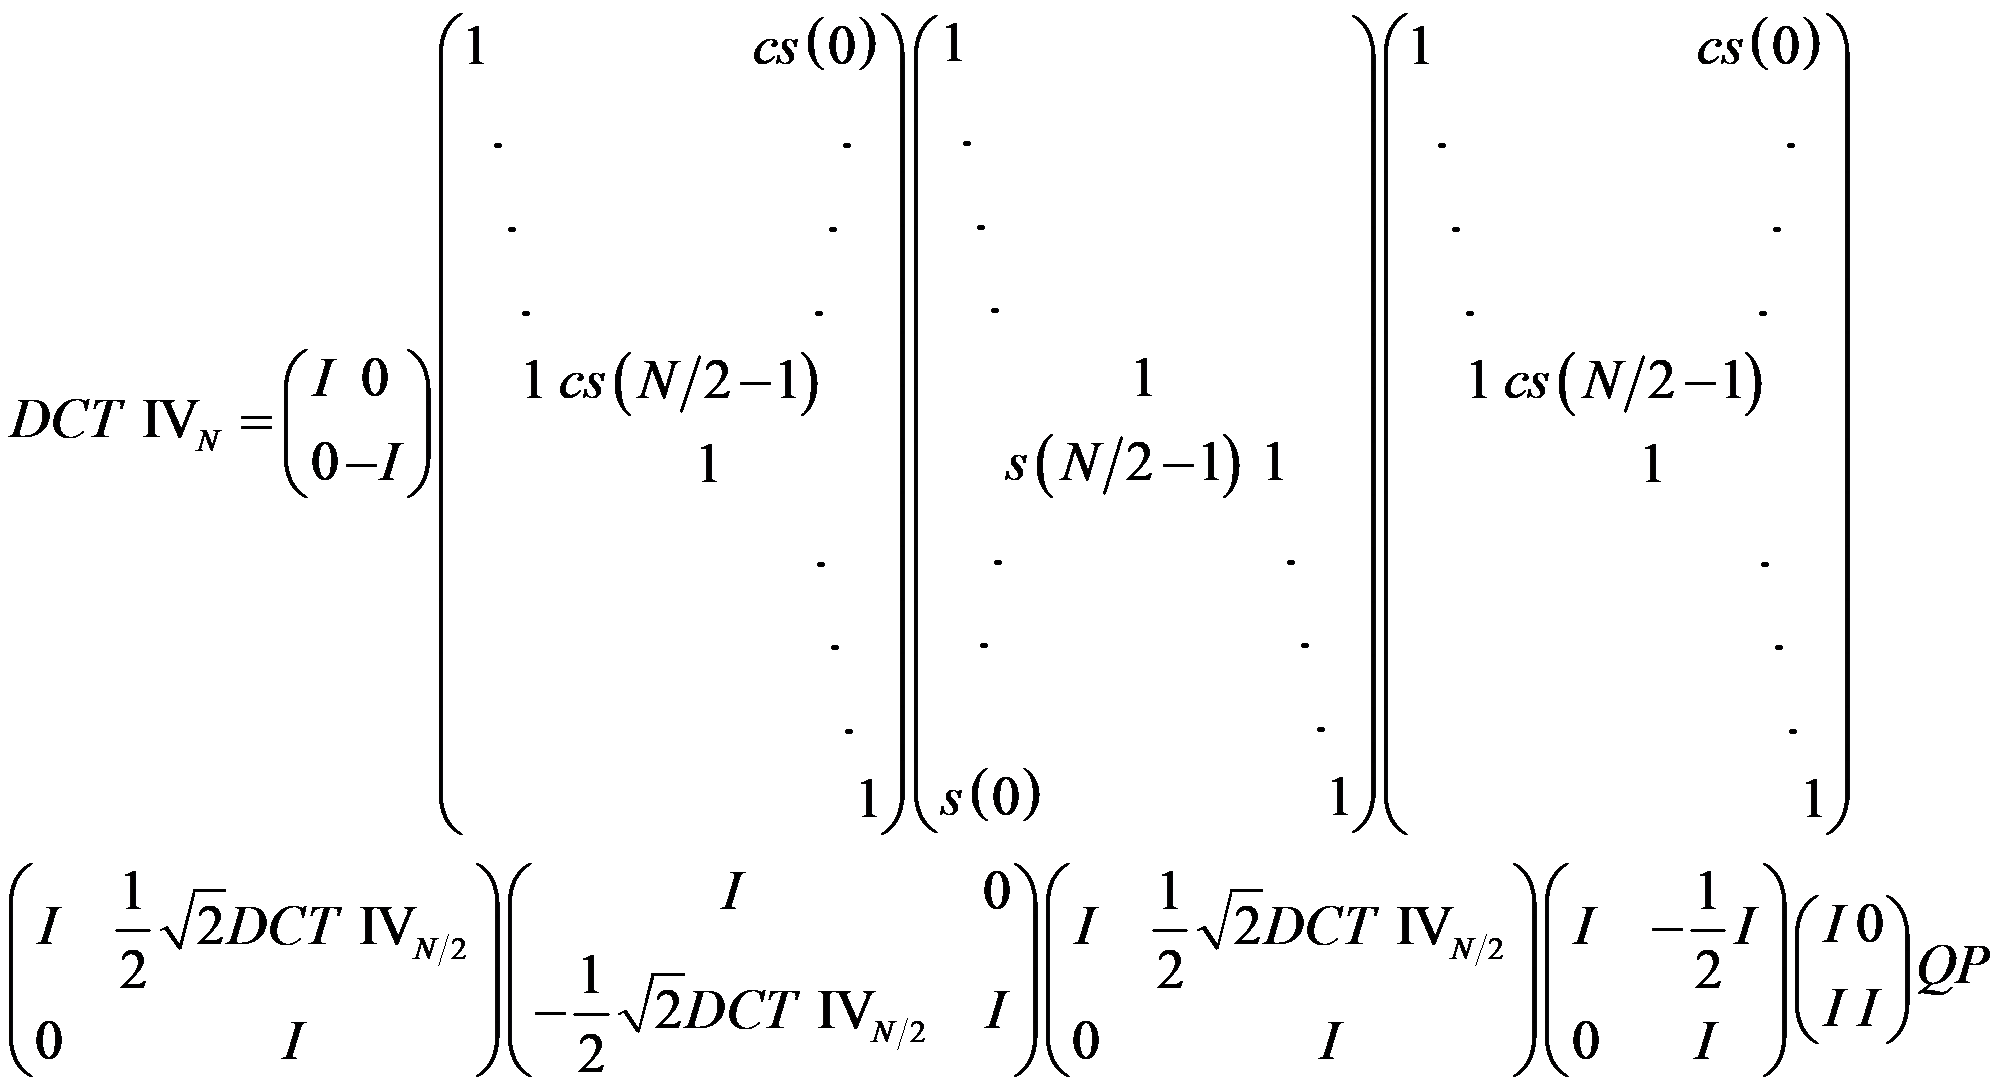
S(k) = sin \frac{(2k + 1)\pi}{4N} , cs(k) = \frac{cos \frac{(2k + 1)\pi}{4N} - 1}{sin \frac{(2k + 1)\pi}{4N}} , k = 0,....., N/2 — 1
и матрицами перестановки P и Q с
P4k, 4k = P4k+1, 4k+1 = P4k+2, 4k+3 = P4k+3, 4k+2 = 1, k = 0,....., N/4 — 1
то есть каждая вторая пара значений переставляется, и
Qk,2k = QN/2+k,2k+1 = 1, k = 0,....., N/2 — 1
то есть четные индексы располагаются в первой половине, нечетные индексы располагаются во второй половине.
Таким образом DCT-IV в основном разлагается на 8 многомерных шагов подъема.
Соответствующее инверсное разложением подъема для инверсного DCT-IV дает выражение:
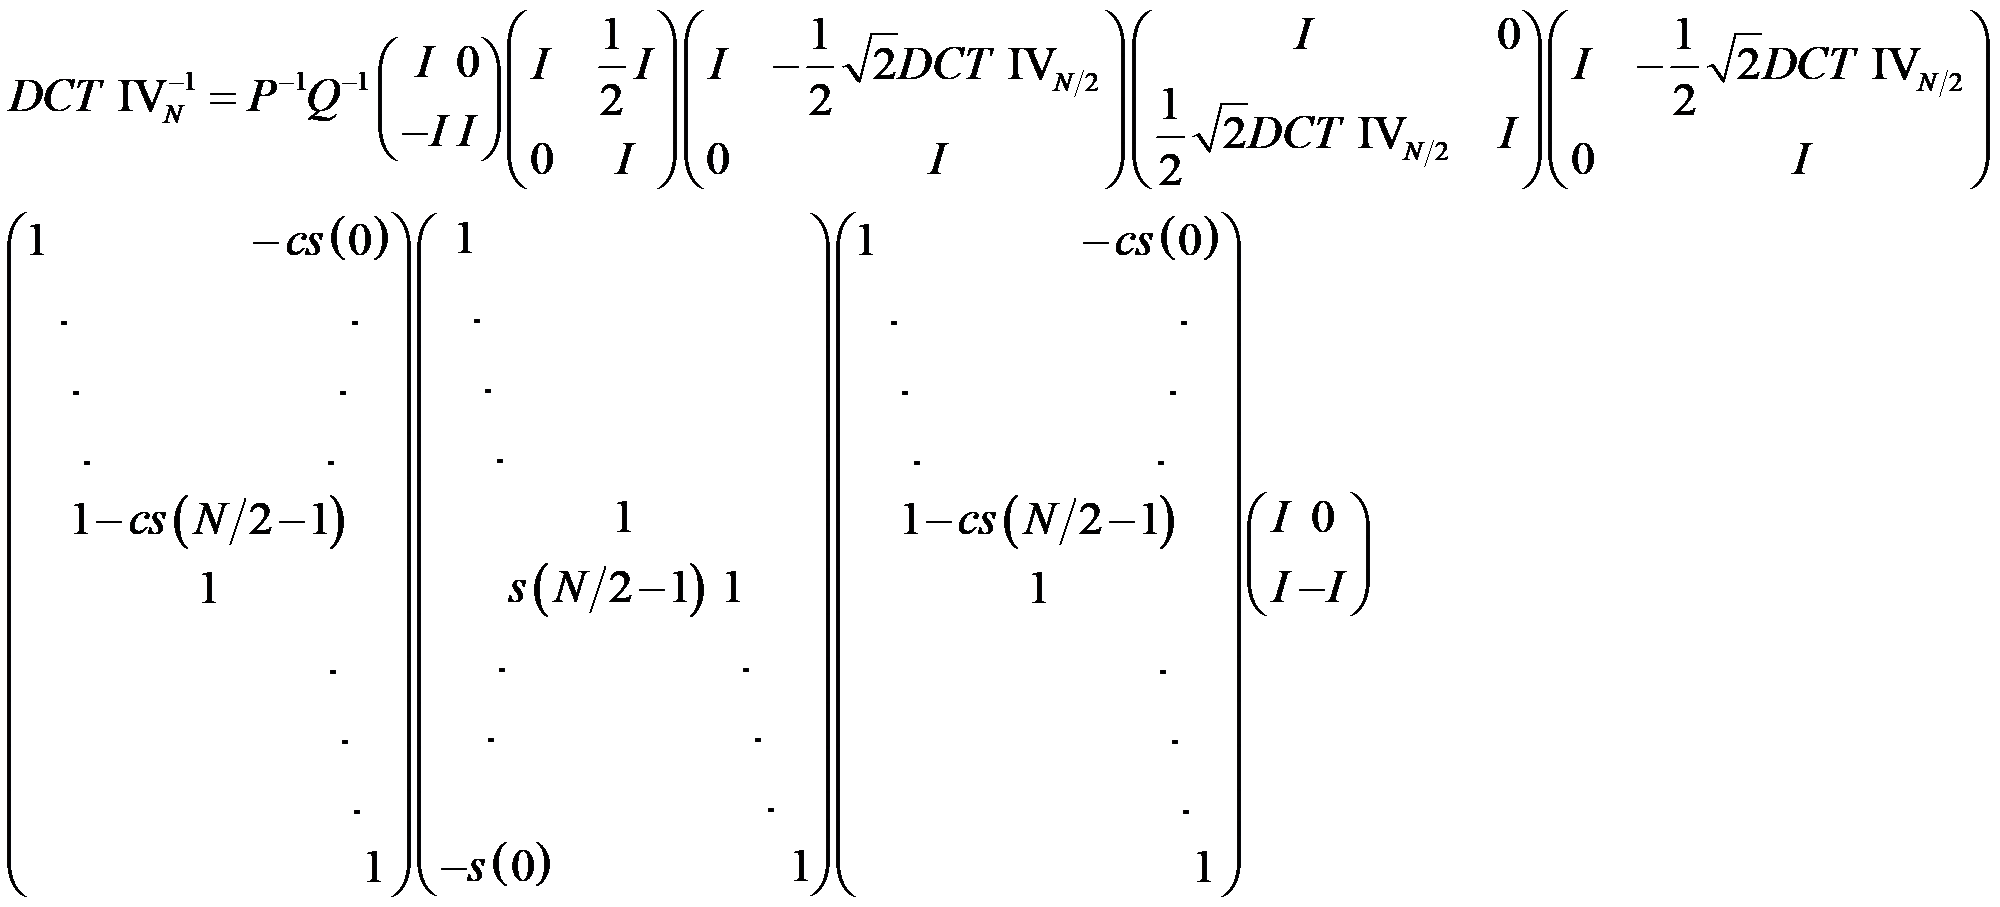
Вычисление Stereo-Int-DCT-IV, используемого для Stereo-IntMDCT.
В случае сигнала стерео, кодированного как channel_pair_element с включенными common_window и use_stereo_intmdct, DCT-IV вычисляется для обоих каналов за один шаг, включая вычисление M/S. Это достигается при использовании разложения Int-DCT-IV, описанного выше, и исключении трех этапов шагов одномерного подъема и двух перестановок, приводя к:
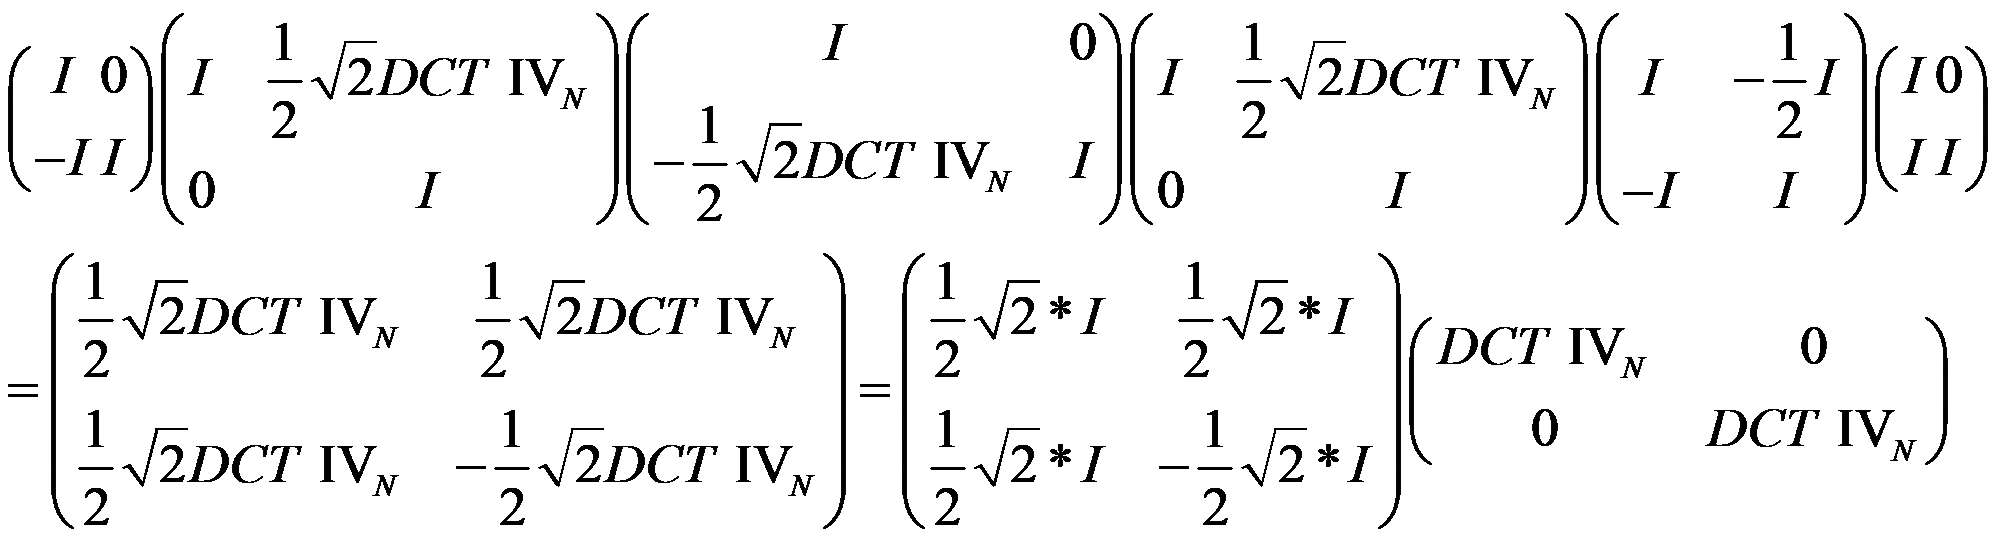
Следовательно это упрощение алгоритма DCT-IV приводит к интегрированному вычислению матрицы M/S и DCT-IV для левого и правого каналов. В этом режиме IntMDCT DCT-IV работает при длине № вместо N/2.
Соответствующее инверсное разложение с подъемом для инверсного Stereo-Int-DCT-IV дается выражением:
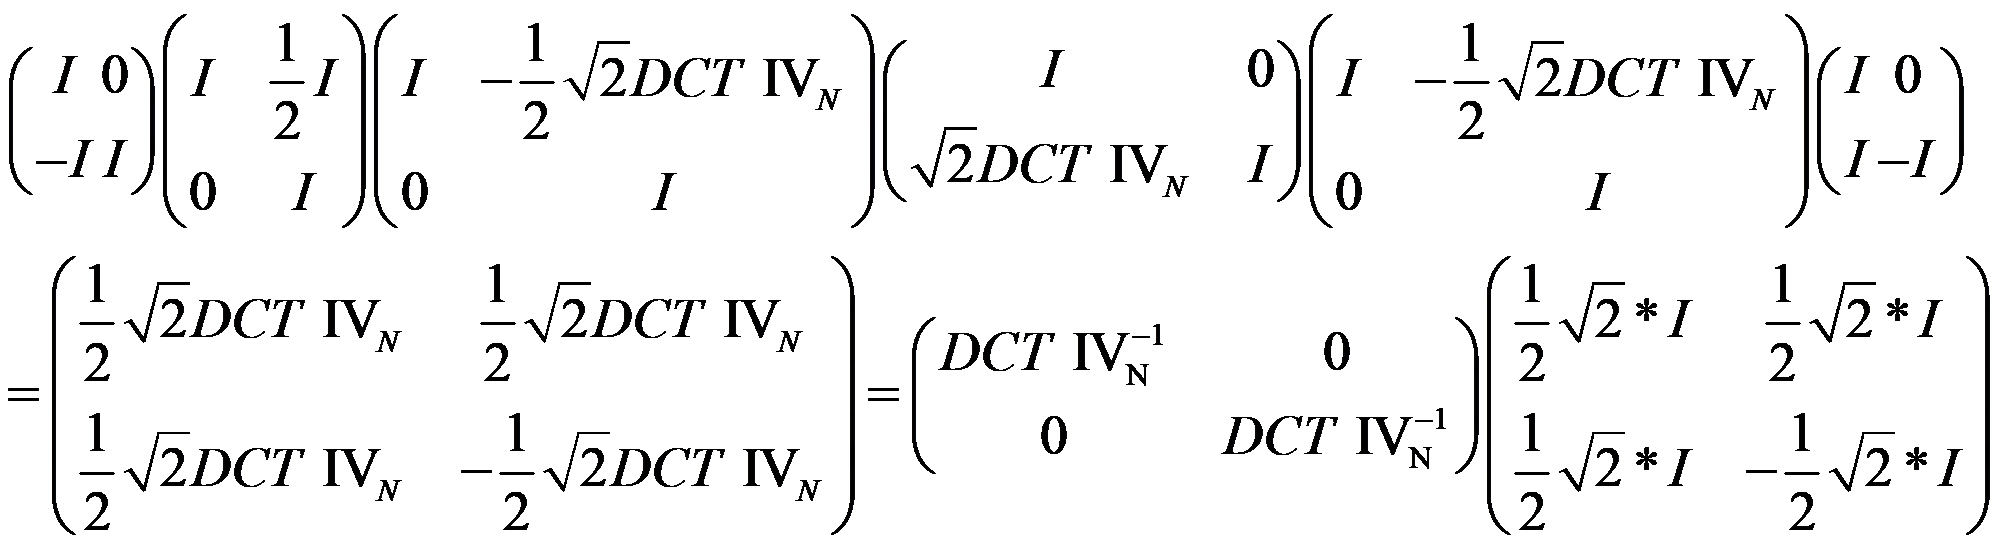
В шагах подъема, где обрабатываются сигналы временного интервала, операции округления соединяются с обратной связью по ошибкам, чтобы обеспечить спектральное формирование шума приближения.
Этот шум приближения влияет на эффективность кодирования без потерь в высокочастотной области, где аудиосигналы обычно содержат очень небольшое количество энергии, особенно на частотах дискретизации 96 кГц и выше. Следовательно низкочастотная характеристика шума приближения улучшает эффективность кодирования без потерь.
Используется фильтр формирования шума первого порядка.
Для IntMDCT этот фильтр применяется к трем этапам шагов подъема в обработке Windowing/TDA и к первому этапу округления обработки Int-DCT-IV.
Для инверсного IntMDCT тот же самый фильтр применяется к трем этапам шагов подъема в обработке Windowing/TDA и к последнему этапу округления обработки инверсного Int-DCT-IV.
5.10.3 Алгоритм для IntMDCT и инверсного IntMDCT
Все операции основаны на вычислениях. Используются следующие форматы:
INT32 для ввода, вывода и промежуточных значений, предопределенных коэффициентов с фиксированной точкой;
INT64 для умножения с коэффициентами с фиксированной точкой, результаты смещаются и сохраняются в INT32 сразу после каждого умножения.
Основные определения для IntMDCT:
Все операции с плавающей запятой в алгоритме выполняются способом с фиксированной точкой. Число дробных битов дается с помощью SHIFT.
Необходимые коэффициенты с плавающей точкой для умножения в шагах подъема и для промежуточных вычислений с фиксированной точкой сохраняются как значения с фиксированной точкой в INT32:
*INT32_coeff = nearestint ((1 <<SHIFT) FLOAT_coeff).
Следующие плавающие коэффициенты сохраняются таким образом:
sineData [k] = sin (kpi/(2SINE_DATA_SIZE)), k=0..., SINE_DATA_SIZE/2,
определенными в sineData [SINE_DATA_SIZE/2+1].
sineData_cs [k] = (1 — cos (kpi/(2SINE_DATA_SIZE)))/sin (kpi/(2SINE_DATA_SIZE)),
определенными в sineData_cs [SINE_DATA_SIZE/2+1].
Соответствующие значения для окна KBD предопределяются в KBDWindow [SINE_DATA_SIZE/2] соответственно KBDWindow_cs [SINE_DATA_SIZE/2].
INT32 multShiftINT32(INT32 x, INT32 y, int shift) { return ((INT32)(((INT64)xy)>>shift)); } INT32 multShiftRoundINT32(INT32 x, INT32 y, int shift) { return (( multShiftINT32(x,y,shift-1) + 1) >> 1 ); } INT32 shiftRoundINT32(INT32 y, INT32 shift) { return (((y>>(shift-1))+1)>>1); } INT32 shiftRoundINT32withErrorFeedback(INT32 y, INT32 errorFeedback, int shift) { y += errorFeedback; result = shiftRoundINT32(y,shift); errorFeedback = (result << shift) — y; return (result); } void rotateINT32(int index, INT32 xin, INT32 yin, INT32 xout, INT32 yout) { xin += multShiftINT32(-sineData_cs[index], yin, SHIFT); yin += multShiftINT32(sineData[index], xin, SHIFT); xin += multShiftINT32(-sineData_cs[index], yin, SHIFT); xout = xin; yout = yin; } void multHalfSqrt2(INT32 x) { x = multShiftINT32(sineData[SINE_DATA_SIZE/2], x, SHIFT); } void rotatePlusMinusINT32(INT32 xin, INT32 yin, INT32 xout, INT32 yout) { xtmp = xin; ytmp = yin; xout = xtmp + ytmp; yout = xtmp — ytmp; } void rotatePlusMinusNormINT32(INT32 xin, INT32 yin, INT32 xout, INT32 yout) { rotatePlusMinusINT32(xin, yin, xout, yout); multHalfSqrt2(xout); multHalfSqrt2(yout); } void addINT32(INT32 xin, INT32* xout, int N) { for (i=0; i<N; i++) xout[i] += xin[i]; } void diffINT32(INT32* xin, INT32* xout, int N) { for (i=0; i<N; i++) xout[i] -= xin[i]; } void copyINT32(INT32* xin, INT32* xout, int N) { for (i=0; i<N; i++) xout[i] = xin[i]; } void shiftLeftINT32(INT32* x, int N, int shift) { for (i=0; i<N; i++) x[i] <<= shift; } void shiftRightINT32(INT32* x, int N, int shift) { for (i=0; i<N; i++) x[i] >>= shift; }
Определения для алгоритма Windowing/TDA:
Алгоритм для прямого соответственно инверсного Windowing/TDA:
if (windowShape == 0) { window = sineData; window_cs = sineData_cs; } else { window = KBDWindow; window_cs = KBDWindow_cs; } errorFeedback = 0; for (i=0; i<N/2; i++) { tmp = multShiftINT32(-window_cs[(2i+1)SINE_DATA_SIZE/(2N)], signal[N-1-i], SHIFT — SHIFT_FOR_ERROR_FEEDBACK); signal[i] -= direction * shiftRoundINT32withErrorFeedback(tmp, &errorFeedback, SHIFT_FOR_ERROR_FEEDBACK); } errorFeedback = 0; for (i=0; i<N/2; i++) { tmp = multShiftINT32(window[(2i+1)SINE_DATA_SIZE/(2N)], signal[i], SHIFT — SHIFT_FOR_ERROR_FEEDBACK); signal[N-1-i] -= direction * shiftRoundINT32withErrorFeedback(tmp, &errorFeedback, SHIFT_FOR_ERROR_FEEDBACK); } errorFeedback = 0; for (i=0; i<N/2; i++) { tmp = multShiftINT32(-window_cs[(2*i+1)SINE_DATA_SIZE/(2N)], signal[N-1-i], SHIFT — SHIFT_FOR_ERROR_FEEDBACK); signal[i] -= direction * shiftRoundINT32withErrorFeedback(tmp, &errorFeedback, SHIFT_FOR_ERROR_FEEDBACK); }
Алгоритм для прямого соответственно инверсного Int-DCT-IV.
Входные значения преобразовываются в прямые соответственно инверсные значения Int-DCT-IV на месте.
В случае Mono IntMDCT signal0[0,..., N — 1] представляет входные значения одного канала, signal1[0,..., N/2 — 1] соответствует верхней половине значений signal0 [N/2,..., N — 1].
Если используется Stereo IntMDCT, длина № является двойной длиной фрейма в алгоритме Int-DCT-IV; signal0 [0,..., N/2 — 1] представляет входные значения левого канала, а signal1 [0,..., N/2 — 1] представляет входные значения правого канала.
Используется временный буфер liftBuffer[k], k = 0,..., N/2 — 1 значений INT32.
Алгоритм для прямого Int-DCT-IV:
if (Mono_IntMDCT) { for (i=0; i<N; i+=4) { (signal0[i+2], signal0[i+3]) = (signal0[i+3], signal0[i+2]); } }
if (Mono_IntMDCT) { for (i=0; i<N; i++) { temp[i] = signal[i]; } for (i=0; i<N/2; i++) { signal[i] = temp[2i]; signal[N/2+i] = temp[2i+l]; } }
addINT32(signal0, signal1, N/2);
liftingStep2and3(signal1, liftBuffer, N);
addINT32(liftBuffer, signal0, N/2);
liftingStep4(signal0, liftBuffer, N);
addINT32(liftBuffer, signal1, N/2);
liftingStep5and6(signal1, liftBuffer, N, Mono_IntMDCT);
addINT32(liftBuffer, signal0, N/2);
liftingStep7(signal0, liftBuffer, N);
addINT32(liftBuffer, signal1, N/2);
liftingStep8(signal1, liftBuffer, N);
addINT32(liftBuffer, signal0, N/2);
Алгоритм для обратного «Int DCT-IV»:
for (k=0; k<N/2; k++) { signal1[k] *=-1; }
Применить инверсные шаги подъема:
if (Mono_IntMDCT) { liftingStep8(signal1, liftBuffer, N); diffINT32(liftBuffer, signal0, N/2); liftingStep7(signal0, liftBuffer, N); diffINT32(liftBuffer, signal1, N/2); } liftingStep5and6(signall, liftBuffer, N, Mono_IntMDCT); diffINT32(liftBuffer, signal0, N/2); liftingStep4(signal0, liftBuffer, N); diffINT32(liftBuffer, signal1, N/2); liftingStep2and3(signal1, liftBuffer, N); diffINT32(liftBuffer, signal0, N/2); diffINT32(signal0, signal1, N/2);
if (Mono_IntMDCT) { for (i=0; i<N; i++) { temp[i] = signal[i]; } for (i=0; i<N/2; i++) { signal[2i] = temp[i]; signal[2i+l] = temp[n/2+i]; } }
if (Mono_IntMDCT) { for (i=0; i<N; i+=4) { (signal0[i+2], signal0[i+3]) = (signal0[i+3], signal0[i+2]); } }
Шаги подъема для прямого и инверсного Int-DCT-IV:
void liftingStep2and3(INT32* signal1, INT32* liftBuffer, int N) { copyINT32(signal1, liftBuffer, N/2); shiftNormalize = DCTIVsqrt2_fixpt(liftBuffer, N/2) + 1; if (shiftNormalize > SHIFT_FOR_ERROR_FEEDBACK) { shiftRightINT32(liftBuffer, N/2, shiftNormalize — SHIFT_FOR_ERROR_FEEDBACK); shiftNormalize = SHIFT_FOR_ERROR_FEEDBACK; } for (k=0; k<N/2; k++) { liftBuffer[k] -= signal1[k] << (shiftNormalize — 1); } errorFeedback = 0; for (k=0; k<N/2; k++) { liftBuffer[k] = shiftRoundINT32withErrorFeedback(liftBuffer[k], &errorFeedback, shiftNormalize); } } void liftingStep4(INT32* signal0, INT32* liftBuffer, int N) { copyINT32(signal0, liftBuffer, N/2); shiftNormalize = DCTIVsqrt2_fixpt(liftBuffer, N/2); for (k=0; k<N/2; k++) { liftBuffer[k] =- shiftRoundINT32(liftBuffer[k],shiftNormalize); } } void liftingStep5and6(INT32* signal1, INT32* liftBuffer, int N, int mono) { copyINT32 (signal1, liftBuffer, N/2); shiftNormalize = DCTIVsqrt2_fixpt(liftBuffer, N/2); shiftRightINT32(liftBuffer, N/2, shiftNormalize); if (mono) { for (k=0; k<N/2; k++) liftBuffer[k] += multShiftINT32(-sineData_cs[step*(2k+1)], signal1[N/2-1-k], (SHIFTS-1)); } for (k=0; k<N/2; k++) liftBuffer[k] = ((liftBuffer[k]+1)>>1); } void liftingStep7(INT32 signal0, INT32* liftBuffer, int N) { for (k=0; k<N/2; k++) liftBuffer[N/2-1-k] = multShiftRoundINT32(sineData[(2k+1)SINE_DATA_SIZE/(2N)], signal0[k],SHIFT); } void liftingStep8(INT32 signal1, INT32* liftBuffer, int N) { for (k=0; k<N/2; k++) liftBuffer[k] = multShiftRoundINT32(-sineData_cs[(2*k+1)SINE_DATA_SIZE/(2N)], signal1[N/2-1-k],SHIFT); }
Как в прямом, так и в инверсном Int-DCT-IV требуется вычисление SQRT(2)*DCT-IV.
Это вычисление выполняется детерминированным способом с фиксированной точкой:
int DCTIVsqrt2_fixpt(INT32 *data, int N) { preShift = msbHeadroomINT32(data, N) — 1; if (preShift > 15) preShift = 15; if (preShift < 0) preShift = 0; shiftLeftINT32(data, N, preShift); preModulationDCT_fixpt(data, xr, xi, N); fftShift = srfft_fixpt(xr, xi, N/2); postModulationDCT_fixpt(xr, xi, data, N); shiftNormalize = (log2int(N) — 2) / 2 + preShift — fftShift; sqrt2Normalize = (log2int(N) — 2) %2; if (sqrt2Normalize) { for (i=0; i<N; i++) multHalfSqrt2(&data[i]); } return shiftNormalize; }
Предварительная модуляция для DCT-IV:
void preModulationDCT_fixpt(INT32 x, INT32 xr, INT32 xi, int N) { for(i=0;i<N/4;i++) { rotateINT32((4i+1)SINE_DATA_SIZE/(2N), x[N-1-2i],x[2i], &xi[i],&xr[i]); rotateINT32((4i+3)SINE_DATA_SIZE/(2N), x[2i+1],-x[N-2-2*i], &xr[N/2-1-i],&xi[N/2-1-i]); } }
void postModulationDCT_fixpt (INT32 xr, INT32 xi, INT32 x, int N) { x [0] = xr [0]; x [N-1] = -xi [0]; for (i=1; i<N/4; i ++) { rotateINT32 (2iSINE_DATA_SIZE/N, xr [i],-xi [i], &x [2i],&x [N-2i-1]); rotateINT32 (2iSINE_DATA_SIZE/N, xr [N/2-i], xi [N/2-i], &x [2i-1], &x [N-2i]); } rotatePlusMinusNormINT32 (xr[N/4], xi[N/4], &x [N/2], &x [N/2-1]); } Split-Radix FFT: int srfft_fixpt(INT32 xr, INT32 xi, int N) { numShifts = 0; / L = 1,2,4,...,N/2 / for (L=I; L<N; L=2) { M = N/L; / M = N, N/2,...,2 / M2 = M/2; M4 = M2/2; / L: number of sub-blocks M: length of sub-block / numShifts += shiftIfRequired(xr, xi, N); for (I=0; I<L; I++) { / butterfly on (x[k],x[M2+k]), k = 0,...,N2-1 on each sub-block / for (k=0; k<M2; k++) { rotatePlusMinusINT32(xr[IM+k],xr[IM+M2+k], &xr[IM+k],&xr[IM+M2+k]); rotatePlusMinusINT32(xi[IM+k],xi[IM+M2+k], &xi[IM+k],&xi[IM+M2+k]); } } numShifts += shiftIfRequired(xr, xi, N); if (M > 2) { for (I=0; I<L; I++) { if (srfftIndex(I) == 0) { /* x[N2+N4+k] -> -jx[N2+N4+k] , k = 0,...,N4-1 on each sub-block / for (k=0; k<M4; k++) { swap(&xr[IM+M2+M4+k],&xi[IM+M2+M4+k]); xi[IM+M2+M4+k] = -1; } } else { / complex multiplications / for (k = 1; k < M4; k++) { rotateINT32(4kSINE_DATA_SIZE/(2M), xi[IM+k],xr[IM+k], &xi[IM+k],&xr[IM+k]); rotateINT32(4kSINE_DATA_SIZE/(2M), -xi[IM+M2-k],-xr[IM+M2-k], &xr[IM+M2-k],&xi[IM+M2-k]); } for (k = 1; 3k < M4; k++) { rotateINT32(43kSINE_DATA_SIZE/(2M), xi[IM+M2+k],xr[IM+M2+k], &xi[IM+M2+k],&xr[IM+M2+k]); rotateINT32(43kSINE_DATA_SIZE/(2M), -xi[IM+M-k],xr[IM+M-k], &xr[IM+M-k],&xi[IM+M-k]); } for (; 3k < 2M4; k++) { rotateINT32(4(M2-3k)SINE_DATA_SIZE/(2M), xi[IM+M2+k],-xr[IM+M2+k], &xr[IM+M2+k],&xi[IM+M2+k]); rotateINT32(4(M2-3k)SINE_DATA_SIZE/(2M), -xi[IM+M-k],-xr[IM+M-k], &xi[IM+M-k],&xr[IM+M-k]); } for (; 3k < 3M4; k++) { rotateINT32(4(3k-M2)SINE_DATA_SIZE/(2M), -xr[IM+M2+k],xi[IM+M2+k], &xi[IM+M2+k],&xr[IM+M2+k]); rotateINT32(4(3k-M2)SINE_DATA_SIZE/(2M), -xr[IM+M-k],-xi[IM+M-k], &xr[IM+M-k],&xi[IM+M-k]); } rotatePlusMinusNormINT32(xi[IM+M4],xr[IM+M4], &xr[IM+M4],&xi[IM+M4]); rotatePlusMinusNormINT32(-xr[IM+M-M4],xi[IM+M-M4], &xr[IM+M-M4],&xi[I*M+M-M4]); } } } } bit_reverse_fixpt(xr, N); bit_reverse_fixpt(xi, N); return numShifts; }
int msbHeadroomINT32(INT32 *x, int N) {
max = 0;
for (i=0; i<N; i++) {
max|= ABS(x[i]);
}
return (30-log2int(max));
}
int shiftIfRequired(INT32 *xr, INT32 *xi, int N) {
shiftRequired = 0;
if ((!msbHeadroomINT32(xr.N))||(!msbHeadroomINT32(xi,N))) {
shiftRequired = 1;
shiftRightINT32(xr, N, 1);
shiftRightINT32(xi, N, 1);
}
return shiftRequired;
}
void bit_reverse_fixpt(INT32 *x, int N) {
for (m=1, j=0; m<N-1; m++) {
for(k=N>>1; (!((j 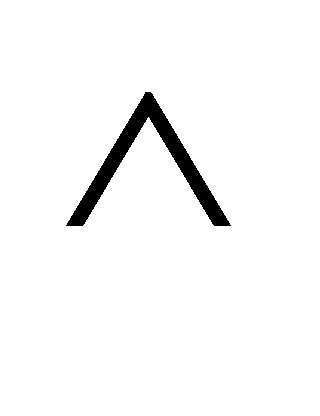 =k)&k)); k>>=1);
if (j>m) swap(&x[m],&x[j]);
}
}
srfftIndexTable[32] = {0, 1, 0, 0, 0, 1, 0, 1, 0, 1, 0, 0, 0, 1, 0, 0,
0, 1, 0, 0, 0, 1, 0, 1, 0, 1, 0, 0, 0, 1, 0, 1};
int srfftIndex(int I) {
return srfftIndexTable[(srfftIndexTable[I>>4]<<4)|(I&0xF)];
}
Обработка прямого и инверсного целочисленного Mid/Side:
void IntMidSideINT32(INT32* 1, INT32* r) /* L/R -> M/S */ { m = *1; s = r; m += multShiftRoundINT32(-sineData cs[SINE DATA SIZE/2], s, SHIFT); s += multShiftRoundINT32( sineDataTsiNE_DATA_SIZE/2], m, SHIFT); m += multShiftRoundINT32(-sineData_cs[SINE_DATA_SIZE/2], s, SHIFT); 1 = s; r = m; } void InverseIntMidSideINT32(INT32 1, INT32 r) / M/S -> L/R */ { m = *1; s = *r; s -= multShiftRoundINT32(-sineData cs[SINE DATA SIZE/2], m, SHIFT); m -= multShiftRoundINT32( sineDataTsiNE_DATA_SIZE/2], s, SHIFT); s -= multShiftRoundINT32(-sineData_cs[SINE_DATA_SIZE/2], m, SHIFT); *1 = s; *r = m; }
5.11 Вычисление табличных значений на основе компактных таблиц
Значения таблиц sineData, sineData_cs, thrMantissa () и invQuantMantissa () вычисляются из компактных таблиц в Приложении Б. Это описывается в следующем псевдокоде:
/ interpolate value between v0 = data[0] and v8 = data[8],* using additionally vm8 = data[-8] and v16 = data[16] / INT32 interpolate Value1to7(INT32 vm8, INT32 v0, INT32 v8, INT32 v16, INT32 I) { INT32 value; INT32 d1, d2, d3; d1 = 2(v8-v0); /* 1 add, 1 shift / d2 = v8-vm8; / 1 add / d3 = v16-v0; / 1 add / if (I==1){ value = v0 + (( 8d2 — d2 + d1 + 64 ) >> 7 ); /* 4 adds, 2 shifts / } else if (I==2) { value = v0 + (( 2d2 + d2 + d1 + 16 ) >> 5 ); /* 4 adds, 2 shifts / } else if (I==3) { value = v0 + (( 16d2 — d2 + 8d1 + d1 + 64 ) >> 7 ); / 5 adds, 3 shifts / } else if (I==4) { value = v0 + (( d2 + d1 + 4 ) >> 3 ); / 3 adds, 1 shifts / } else if(I==5) { value = v8 — (( 16d3 — d3 + 8d1 + d1 + 64 ) >> 7 ); / 5 adds, 3 shifts / } else if (I==6) { value = v8 — (( 2d3 + d3 + d1 + 16 ) >> 5 ); /* 4 adds, 2 shifts / } else if (I==7) { value = v8 — (( 8d3 — d3 + d1 + 64 ) >> 7 ); /* 4 adds, 2 shifts */ } return value; }
INT32 interpolateFromCompactTable(int index, INT32* compactTable) { INT32 value; j = index%8; k = index/8; if (j == 0) { value = compactTable[k+1]; return value; } value = interpolateValue1to7(compactTable[k], compactTable[k+1], compactTable[k+2], compactTable[k+3], j); return value; }
Значения для таблиц sineData и sineData_cs вычисляются, применяя sineData[index] = interpolateFrom CompactTable(index, sineDataCompact) и sineData_cs[index] = interpolateFromCompactTable(index, sineDataCompact_cs).
Значения для функции invQuantMantissa () вычисляются согласно
INT32 invQuantMantissa(int quant, int res)
{
INT32 value;
INT32 pow_2_quat[4] = {0, 1276901417, 1518500250, 1805811301};
/* (int)(pow(2.0,res/4.0)*(1<<SHIFT)+0.5) /
if (quant < MAX_INV_QUANT_TABLE) {
value = invQuantCompact[quant];
if (res > 0) {value = multShiftRoundINT32(value, pow_2_quat[res], SHIFT);}
} else {
I = quant%8;
k = quant/8;
if (I == 0; {value = invQuantMantissa(k, res)<<4; / 8 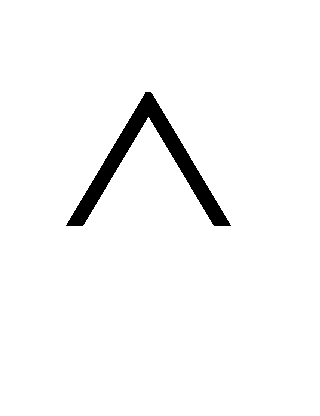 (4/3) = 16 = 2
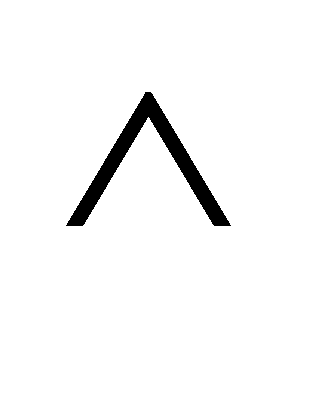 4 */
} else {
value = interpolateValue1to7(invQuantMantissa(k-1, res)<<4,
invQuantMantissa(k, res)<<4,
invQuantMantissa(k+1, res)<<4,
invQuantMantissa(k+2, res)<<4.
I);
}
}
return value;
}
Значение для функции thrMantissa () вычисляется согласно
INT32 thrMantissa(quant, res) { INT32 value; INT32 invQuant0; INT32 invQuant1; if (quant < MAX_THR_TABLE) { value = thrCompact[res][quant]; } else { invQuant0 = invQuantMantissa(quant,res); invQuant1 = invQuantMantissa(quant+1,res); value = invQuant1 +(((invQuant0-invQuant1)*13)>>5); } return value; }
Кодер SLS генерирует для данного аудиовхода PCM поток битов без потерь, который может декодироваться в разрядно-точную репродукцию PCM данного аудио при использовании декодера SLS. Кроме того поток без потерь, сгенерированный кодером SLS, может быть усеченным, чтобы понизить скорости передачи до скорости передачи базового кодера MPEG-4 GA. Таким образом получающийся поток битов может декодироваться декодером SLS, чтобы образовать репродукцию исходного аудио с потерями таким способом, что лучшая точность сигнала всегда достигается с более высокими скоростями в уровне LLE.
А.1.1 Кодирование с передискретизацией
Для процесса кодирования, включающего метод передискретизации, возможны два подхода: субдискретизация в домене MDCT и субдискретизация во временном интервале.
Входной сигнал при субдискретизации в домене MDCT обрабатывается IntMDCT длины osf* 1024, и первые 1024 спектральных значения подаются в кодер MPEG-4 GA.
Для второго возможного подхода кодирования входной сигнал субдискретизируется во временном интервале и параллельно выполняется полная часть кодирования AAC.
IntMDCT описывался в нормативной части.
Существуют два типа окна, которые используются в реализации SLS. Они такие же как при работы с окнами AAC. Одно является длинным окном с коэффициентами IntMDCT osf* 1024, другое — короткое окно с коэффициентами IntMDCT osf* 128. К оконной аудиопоследовательности применяется целочисленное преобразование. Когда используется короткое окно, набор коэффициентов osf* 1024 IntMDCT обрабатывается как матрица 8 частотными коэффициентами osf* 128, представляющими время-частотную эволюцию сигнала на протяжении восьми коротких окон. Тот же самый процесс группировки и чередования, принятый в AAC, применяется здесь. Чтобы быть определенными, предположим, что перед чередованием набор с коэффициентов osf* 1024 IntMDCT индексируются как c [g] [w] [b] [k], где
w — индекс окон в пределах группы;
b — индекс полос масштабного коэффициента в пределах окна;
k — индекс коэффициентов в пределах полосы масштабного коэффициента и самый правый индекс изменяется наиболее быстро.
После чередования коэффициенты индексируются как c [g] [b] [w] [k].
В последующих разделах, когда используется короткое окно, предполагают, что сигнальный процесс выполняется на чередующемся спектре для восьми коротких рамок окна, если не определено иное.
Если для левого и правого каналов используется Mono IntMDCT, там, где флаг M/S устанавливается в '1', к полосам масштабного коэффициента должна быть применена целочисленная обработка M/S.
Stereo IntMDCT поставляет по умолчанию спектр M/S. Следовательно M/S должно быть выключено для полос масштабного коэффициента там, где оно не требуется.
А.5 Нормализация перед кодированием AAC
После IntMDCT масштабный коэффициент core_scaling используется, чтобы нормализовать коэффициенты c(k) IntMDCT для каждой полосы масштабного коэффициента sfb, чтобы обеспечить базовый входной спектр уровня AAC c' (k).
После IntMDCT при нормализации коэффициентов c(k) IntMDCT для каждой полосы масштабного коэффициента sfb используется масштабный коэффициент core_scaling, чтобы обеспечить входной спектр базового уровня AAC c' (k).
где значение масштабного коэффициента core_scaling совместно определяется типом соответствующей полосы масштабного коэффициента и длиной слова входного аудио, данными в следующей таблице:
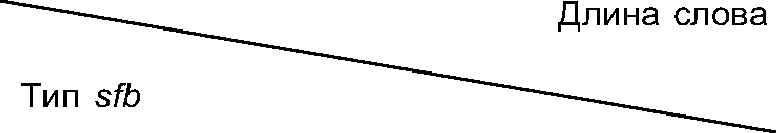
После нормализации нормализованный c' квантуется базовым квантователем AAC, чей индекс квантования вывода i затем кодируется по Хаффману. Потом он мультиплексируется с необходимой дополнительной информацией, например масштабным коэффициентом scale_factor(sfb), используемым в квантователе для каждой полосы масштабного коэффициента sfb согласно синтаксису потока битов AAC, чтобы генерировать базовый поток битов AAC.
В уровне LLE процедура отображения ошибок используется, чтобы удалить информацию, которая уже была кодирована в базовом уровне. Ввод в модуль отображения ошибок является 1024 коэффициентами c[sfb][k] IntMDCT в диапазоне непередискретизации и его соответствующим квантованным значением в базовом кодере quant[sfb] [k]. Его вывод является остаточным спектром IntMDCT res.
В SLS остаточный спектр IntMDCT res кодируется кодирующим процессом BPGC/CBAC, который состоит из следующих шагов:
определение параметра BPGC/CBAC;
кодирование разрядной матрицы остаточных целочисленных спектральных данных;
кодирование низкоэнергетического режима остаточных целочисленных спектральных данных.
А.7.1 Определение параметра BPGC/CBAC
Как первый шаг идентифицируются максимальные разрядные матрицы max_bp для каждой полосы масштабного коэффициента. Для Implicit_Band максимальная разрядная матрица M для каждых остаточных спектральных данных может быть вычислена из
M[g] [win] [sfb] [bin] = INT {log2 [interval [g] [win] [sfb] [bin]]},
где interval[g][win][sfb][bin] является интервалом квантования AAC.
Для Explicit_Band, M дается как:
M[g] [win] [sfb] [bin] = INT {log2 |res [g] [win] [sfb] [bin]|},
и далее определяем log20=-1 для вышеупомянутого вычисления log. Максимальная разрядная матрица max_bp для каждой полосы масштабного коэффициента является максимальным значением M для спектральных данных, которые принадлежат sfb:
max_bp[g] [sfb] = max (M [g] [win] [sfb] [bin])
После обнаружения max_bp для каждой полосы масштабного коэффициента lazy выбирается из трех возможных значений max_bp-1, max_bp-2 и max_bp-3.
А.7.2 Кодирование разрядной матрицы остаточных целочисленных спектральных данных
Следующий псевдокод иллюстрирует, как кодируются знак и амплитуда остаточных спектральных данных IntMDCT res в потоке данных BPGC/CBAC. Элемент справки M для незначащей полосы масштабного коэффициента устанавливается в значение max_bp, чтобы быть совместимым с процессом декодирования. На полосах масштабного коэффициента, для которых lazy_bp > 0, выполняется процесс кодирования BPGC/CBAC.
/ preparing of help elements / for (g=0;g<num_window_groups;g++){ for (sfb = 0;sfb<num_sfb;sfb++){ width = swb_offset[g][sfb+1] — swb_offset[g][sfb]; for (win = 0;win <window_group_len[g];win++) { for (bin=0;bin<width;bin++) is_sig[g][win][sfb][bin]= ((quant[g][sfb][win][bin])&&(band_type[g][sfb]==Implicit_band))?1:0; } cur_bp[g][sfb] = max_bp[g][sfb]; } } / BPGC/CBAC normal coding process / while ((there exists max_bp[g][sfb]-i >= 0) && (i<LAZY_BP)){ for (g=0;g<num_window_groups;g++){ for (sfb = 0;sfb<num_sfb;sfb++){ if ((cur_bp[g][sfb]>=0) && (lazy_bp[g][sfb] > 0)){ width = swb_offset[g][sfb+1] — swb_offset[g][sfb]; for (win=0;win<window_group_len[g];win++){ for (bin=0;bin<width;bin++){ sym = (abs(res[g][win][sfb][bin])&(1<<cur_bp[g][sfb]))?1:0; sgn = (sign(res[g][win][sfb][bin])+1)/2; if (interval[g][win][sfb][bin]>res[g][win][sfb][bin]+(1<<cur_bp[g][sfb]) { encode(sym,freq); / encode bit-plane cur_bp*/* if ((!is_sig[g][win][sfb][bin])&&(sym)){ encode(sgn,freq_sign); / encode sign bit if necessary * /* is_sig[g][win][sfb][bin] = 1; } } } } } } cur_bp[g][sfb]--; } } } The BPGC/CBAC lazy coding mode is started after the first NUM_BP bit-planes have been coded. / BPGC/CBAC lazy coding process / flush_encode(); / flush the AC encoder before lazy coding / while (there exists max_bp[g][sfb]-i >= 0){ for (g=0;g<num_window_groups;g++){ for (sfb = 0;sfb<num_sfb;sfb++){ if ((cur_bp[g][sfb]>=0) && (lazy_bp[g][sfb] > 0)){ width = swb_offset[g][sfb+1] — swb_offset[g][sfb]; for (win=0;win<window_group_len[g];win++){ for (bin=0;bin<width;bin++){ sym = (abs(res[g][win][sfb][bin])&(1<<cur_bp[g][sfb]))?1:0; sgn = (sign(res[g][win][sfb][bin])+1)/2; if (interval[g][win][sfb][bin]>res[g][win][sfb][bin]+(1<<cur_bp[g][sfb]) { write_bit(sym); / encode bit-plane cur_bp*/* if ((!is_sig[g][win][sfb][bin])&&(sym)){ write_bit(sgn); / encode sign bit if necessary / is_sig[g][win][sfb][bin] = 1; } } } } } cur_bp[g][sfb]--; } } }
А.7.3 Кодирование кодом низкоэнергетического режима (LEMC)
Для полос масштабного коэффициента с lazy_bp = 0, -1, -2, и -3 остаточные спектральные данные res не кодируются BPGC/CBAC. Вместо этого они кодируются процессом кодирования LEMC. В низкоэнергетическом режиме амплитуда остаточных спектральных данных res сначала конвертируется в двоичный формат, как перечислено в таблице 26. Получающаяся двоичная строка затем кодируется арифметически. Процесс низкоэнергетического режима кодирования выполняется непосредственно после того, как завершается процесс кодирования BPGC.
Процесс низкоэнергетического режима кодирования иллюстрируется следующим псевдокодом:
for (g = 0;g < num_window_groups; g++){ for (sfb = 0; sfb <num_sfb+num_osf_sfb;sfb++){ if ((cur_bp[g][sfb] >= 0) && (lazy_bp[g][sfb] <= 0)) { width = swb_offset[g][sfb+1] — swb_offset[g][sfb]; for (win=0;win<window_group_len[g];win++){ pos = 0; for (bin=0;bin <width;bin++){ if (!is_lle_ics_eof ()){ amp = abs(res[g][sfb][win][bin]); sgn = (sign(res[g][sfb][win][bin]) + 1)/2; dumb = amp; while (dumb > 0) {/* binarize and encoding for non-zero res*/ encode(1,freq_silence[position]); position++; if (position>2) position = 2; dumb --; } if (amp != (1<<(max_bp[g][win][sfb] + 1)) — 1) encode(0,freq_siience[position]); /* encode of terminating 0 / if (amp) encode(sgn,freq_sgn); / encode of sign symbol*/ } } } } } } }
Следующий псевдокод объясняет, как в BPGC/CBAC арифметически кодируется двоичный символ и процессы низкоэнергетического режима кодирования.
#Idefine CODE_WL 16 #Idefine PRE_SHT 14 #Idefine TOP_VALUE (((long) / < < CODE_WL)-1) #Idefine QTR_VALUE (TOP_VALUE/4+1) #Idefine HALF_VALUE (2QTR_VALUE) #Idefine TRDQTR_VALUE (3 QTR_VALUE)
void encode(int sym, int freq) { range = (long)(high-low)+1; if (sym) high = low + (rangefreq>>PRE_SHT)-1; else low = low + (rangefreq>>PRE_SHT); for (;;) { if (high<HALF_VALUE) { output_bit(0); while (fbits > 0) { output_bit (1); fbits --; } } else if (low>=HALF_VALUE) { output_bit(1); while (fbits > 0) { output_bit (0); fbits --; } low -= HALF_VALUE; high -= HALF_VALUE; } else if (ow>=QTR_VALUE && high<TRDQTR_VALUE) { fbits += 1; low -= QTR_VALUE; high -= QTR_VALUE; } else break; low = 2low; high = 2high+1; return; }
/* flush the state register of AC encoder*/ flush_encode() { fbits += 1; if (low < QTR_VALUE) output_bit(0); while (fbits > 0) { output_bit (1); fbits --; } else output_bit(1); while (fbits > 0) { output_bit (0); fbits --; }
А.8 Метод усечения потока битов путем его повторного анализа
Полный поток битов SLS может быть усечен при любой данной целевой скорости передачи простым способом. Модификация значений lle_ics_length не влияет на результаты декодирования LLE перед точкой усечения, так как lle_ics_length независимо от процедуры декодирования LLE. Усечение потока битов может быть выполнено следующим образом:
1. Считать lle_ics_length из потока битов;
3. Вычислить доступную длину фрейма в данной целевой скорости передачи. Самый простой способ вычислить доступную длину фрейма следующий:
target_bits = (int) (target_bitrate/2.*1024.*osf/sampling_rate+0.5)-16;
target_bytes = (target_bits+7)/8.
Переменная target_bitrate представляет целевую скорость передачи, бит/с. Переменная osf представляет фактор передискретизации. Переменная sampling_rate представляет частоту дискретизации входного аудиосигнала, Гц;
4. Обновить lle_ics_length, взяв минимум доступной длины фрейма и текущей длины фрейма.
lle_ics_length = min (lle_ics_length, target_bytes);
5. Генерировать усеченный поток битов с обновленным lle_ics_length.
Получающийся усеченный поток битов декодируется методом интеллектуального арифметического декодирования, как описано в 5.5.2.5.
ТАБЛИЦЫ ДЛЯ ПРЕДОПРЕДЕЛЕННЫХ КОЭФФИЦИЕНТОВ С ФИКСИРОВАННОЙ ТОЧКОЙ
define MAX_INV_QUANT_TABLE 1025
| [1] | ИСО/МЭК 14496-3:2009 | Информационные технологии. Кодирование аудиовизуальных объектов. Часть 3. Аудио (ИСО/МЭК 14496-3:2009 Information technology — Coding of audio-visual objects — Part 3: Audio) |
|---|