МИ 656-84. Методические указания. Оценка достоверности численных данных о свойствах нефти и нефтепродуктов
(утв. и введены в действие Протоколом НТС ВНИЦ ПВ от 11.12.1984 № 13)
Утверждены и введены в действие Протоколом научно-технического совета ВНИЦ ПВ от 11 декабря 1984 г. № 13
ОЦЕНКА ДОСТОВЕРНОСТИ ЧИСЛЕННЫХ ДАННЫХ О СВОЙСТВАХ НЕФТИ И НЕФТЕПРОДУКТОВ
РАЗРАБОТАНЫ Казанским филиалом Всесоюзного ордена Трудового Красного Знамени научно-исследовательского института физико-технических и радиотехнических измерений (ВНИИФТРИ); Всесоюзным научно-исследовательским центром по изучению свойств поверхности и вакуума (ВНИЦ ПВ)
В.Г. Гизатуллина, канд. техн. наук А.Д. Козлов (руководитель темы)
ВНЕСЕНЫ Казанским филиалом ВНИИФТРИ
УТВЕРЖДЕНЫ И ВВЕДЕНЫ В ДЕЙСТВИЕ научно-техническим советом ВНИЦ ПВ от 11 декабря 1984 г. (протокол № 13)
Настоящие методические указания устанавливают единые принципы оценки достоверности данных о физико-химических и эксплуатационных свойствах нефти и нефтепродуктов.
1. ОБЩИЕ ПОЛОЖЕНИЯ
1.1. Оценку данных о свойствах нефти и нефтепродуктов проводят с целью определения степени достоверности этих данных, установления числового интервала их погрешности и отбора наиболее надежных данных для обеспечения потребности народного хозяйства достоверной информацией о свойствах нефти и нефтепродуктов, необходимой при оценке их качества.
1.2 Под оценкой достоверности численных данных понимают:
выбор и обоснование методов отбора и анализа исходных данных;
нахождение оптимальных требований к методам и средствам измерений, применяемых при исследовании показателя или свойства;
выбор и обоснование методов анализа и обобщения данных для конкретной области их применения;
определение алгоритмов обработки данных.
1.3. При оценке достоверности численных данных о свойствах нефти и нефтепродуктов необходимо руководствоваться ГОСТ 8.344-79, ГОСТ 22013-76, ГОСТ 8.326-78, МУ 38.101003-81, РД 50-262-81, РД 50-326-82.
2. ОТБОР ИСХОДНЫХ ДАННЫХ
2.1. При отборе численных данных о свойствах нефти и нефтепродуктов необходимо учитывать следующие характеристики продуктов и их свойств:
марку продукта и его назначение;
технологию получения продукта;
условия транспортировки и хранения;
метод определения продукта и его свойств.
2.2. Исходной информацией при отборе численных данных о свойствах нефти и нефтепродуктов являются результаты испытаний, полученные: стандартизованными методами; методами, включенными в комплексы квалификационной оценки; нестандартизованными методами, прошедшими метрологическую аттестацию в соответствии с МУ 38.101003-81; на специальных установках, прошедших метрологическую аттестацию в соответствии с ГОСТ 8.326-78.
2.3. При отборе данных предпочтительно использовать результаты, полученные по аттестованным методикам (РД 50-326-82).
3. ОБРАБОТКА ЧИСЛЕННЫХ ДАННЫХ
3.1. Настоящие методические указания рекомендуют оценивать данные двумя величинами: математическим ожиданием M и дисперсией \sigma^{2} при заданном уровне значимости \alpha = 0,05 . В основу определения этих величин положено следующее предположение: результаты испытаний x1, x2, ..., xn являются независимыми в совокупности величинами и распределены по нормальному закону.
3.2. Качественное заключение о нормальности распределения получают графическим путем, используя метод гистограмм (рекомендуется для случая, когда n > 50). Если объем имеющихся численных данных недостаточен (n < 50), то гистограмму строят по совокупности малых выборок. Однако строить гистограмму в этом случае возможно, если выборки малого объема проверены попарно на однородность.
3.3. Однородность выборок проверяют по критерию Вилкоксона и его модификации — критерию Манна — Уитни. Пусть x1, ..., x_{n_{1}} , x'2, ..., x_{n}\prime_{2} — данные двух выборок. Обозначим через Ux'<x число пар (xi; x'j), где x'j < xi. Приведенная статистика Манна-Уитни (Ux'<x) линейно связана со статистикой Вилкоксона (Tx; Tx') соотношением
Ux'<x = n1·n2 + n1(n1 + 1)/2 — Tx' = = Tx — n2(n2 + 1)/2, (1)
где n1, n2 — число данных в каждой выборке.
Для нахождения статистики Tx и Tx' из двух выборок составляется общий вариационный ряд x_{(1)}<x_{(2)}<...<x_{(n_{1} + n_{2})} , в котором для одного значения xi определяют номер места <*> ri — ранг. Аналогично определяют ранги aj для одного значения x'j.
<*> Если два или более значения совпадают, то им приписывают один и тот же ранг, равный среднему арифметическому рангов, несовпавших значений.
T_{x} = \sum_{i = 1}^{n_{1}} r_{i};T_{x\prime} = \sum_{j = 1}^{n_{2}} a_{j} (2)
Однородность выборок не отвергается, если эмпирическое значение Ux'<x превосходит табличное значение Uтабл (при уровне значимости \alpha = 0,05 ).
Значения Uтабл представлены в табл. 1 приложения 1 при условии
{}_{P}{_{U_{x\prime<x} \leq U_{\text{табл}}}}_{\leq \alpha} .
Критерий Вилкоксона применим для любого вида распределения и не требует большого числа данных в каждой выборке (n >= 5).
Однородность выборок по критерию Вилкоксона и Манна — Уитни выявляется как по форме распределения, так и по средним.
3.4. Если гипотеза об однородности выборок не противоречит данным общей выборки, то выполняют проверку крайних значений по ГОСТ 11.002-73 при уровне значимости, равном \alpha = 0,05 , и строят гистограмму.
3.5. Проверку нормальности закона распределения выполняют с помощью коэффициентов асимметрии и эксцесса, согласно приложению I ГОСТ 22013-76.
3.6. Рассчитывают параметры распределения: среднее арифметическое \overline{x_{i}} и среднее квадратическое отклонение Si для каждой i-й выборки общей выборки.
4. ПРОВЕРКА СОГЛАСОВАННОСТИ
4.1. Проверку согласованности данных выполняют по сумме минимального отклонения оценок дисперсий каждой i-й выборки общей выборки (n >= 5). Наилучшей оценкой в этом случае является среднее взвешенное \overline{x} :
\overline{x} = \frac{\sum_{i = 1}^{L} \overline{x_{i}}S_{i}^{2}}{\sum_{i = 1}^{L} 1S_{i}^{2}} , (3)
где S2i — дисперсия каждой i-й выборки; L — число всех выборок.
Согласованность данных не отвергается, если сохраняется условие
где F — число степеней свободы (F = N — L) при уровне значимости \alpha = 0,05 ; N — число всех данных; A2min - вычисленное значение, равное
A_{min}^{2} = \sum_{i = 1}^{L} \frac{(\overline{x_{i}} - \overline{x})^{2}}{S_{i}^{2}} . (5)
4.2. Если вычисленное значение A2min превышает ожидаемое значение F, то рекомендуется выполнить анализ накопленных данных и выявить факторы, влияющие на их разброс.
4.3. Для приведения численных данных к согласию в ряде случаев (для фундаментальных констант) рекомендуется использовать расчетный коэффициент Берджа. Согласование численных данных по коэффициенту Берджа выполняют в соответствии с рекомендованным приложением 2.
5. ДОВЕРИТЕЛЬНЫЕ ГРАНИЦЫ СРЕДНЕЙ АРИФМЕТИЧЕСКОЙ И СРЕДНЕГО КВАДРАТИЧЕСКОГО ОТКЛОНЕНИЯ
5.1. Анализ точности данных чаще основан на подсчете точечных оценок. Однако ошибки, допускаемые в процессе испытаний, приводят к большому разбросу данных, который не позволяет объективно оценить исследуемое свойство. Поэтому наряду с вычислением точечных оценок рекомендуется использовать интервальные. Интервальное оценивание в данном случае основано на построении доверительных интервалов для выборочной средней \overline{x_{i}} и для выборочной дисперсии S2i при доверительной вероятности P = 0,95.
В табл. 1 приложения 4 дан пример вычисления точечных и интервальных оценок.
5.1.1. При построении доверительного интервала для выборочной средней \overline{x_{i}} используют распределение Стьюдента. Из таблиц распределения Стьюдента с ni — 1 степенями свободы находят величину t_{n_{i} - 1} , для которой справедливо равенство
P\{ - t_{\alpha 2}< \frac{(\overline{x_{i}} - M)}{S_{i}} \cdot \sqrt{n_{i}} <t_{\alpha 2}\} \geq 1 - \alpha . (6)
Преобразуя выражение (6), строят двусторонний доверительный интервал для каждой i-й выборки:
\overline{x_{i}} - \frac{s_{i} \cdot t_{\alpha 2}}{\sqrt{n_{i}}} <M<\overline{x_{i}} + \frac{S_{i} \cdot t_{\alpha 2}}{\sqrt{n_{i}}} , (7)
где 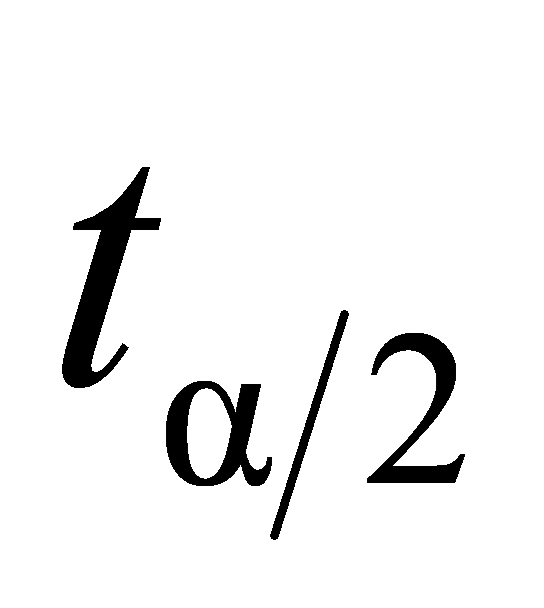 - квантили уровня 1 - \alpha 2 ,
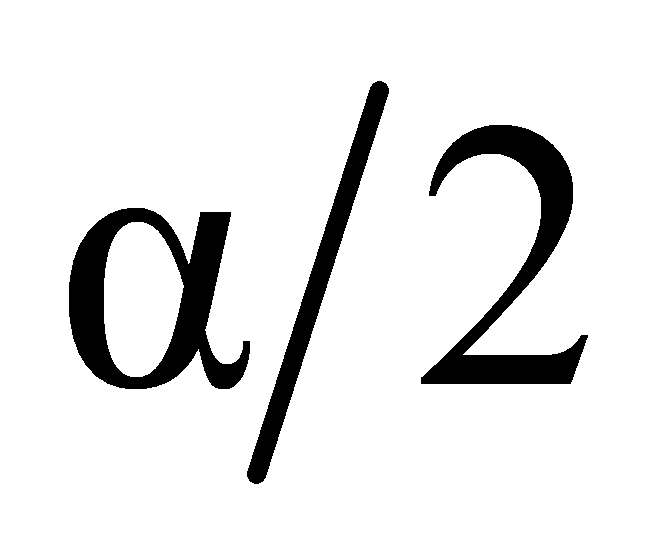 ; ni — число данных в i-й выборке.
5.1.2. Доверительный интервал для выборочной дисперсии S2i строят на основании того, что случайная величина (n_{i} \cdot S_{i}^{2})\sigma^{2} имеет распределение \chi^{2} с ni — 1 степенями свободы, т.е. n_{i} \cdot S_{i}^{2}\sigma^{2} \sim \chi_{n_{i} - 1}^{2} , где \sigma^{2}>n_{i} \cdot S_{i}^{2}\chi_{n_{i} - 1}^{2} .
Доверительный интервал для выборочной дисперсии строят из условия
P\{\chi_{n_{i} - 1,\alpha 2}^{2} \leq \frac{n_{i} \cdot S_{i}^{2}}{\sigma^{2}} \leq \overline{\chi_{n_{i} - 1,\alpha 2}^{2}}\} \geq 1 - \alpha . (8)
Преобразуя выражение (8) в P\{ \frac{1}{\chi_{n_{i} - 1,\alpha 2}^{2}} <\sigma^{2}< \frac{1}{\overline{\chi_{n_{i} - 1,\alpha 2}^{2}}} \} \geq 1 - \alpha , строят двусторонний доверительный интервал
P\{ \frac{n_{i} \cdot S_{i}^{2}}{\chi_{n_{i} - 1,\alpha 2}^{2}} <\sigma^{2}< \frac{n_{i} \cdot S_{i}^{2}}{\overline{\chi_{n_{i} - 1,\alpha 2}^{2}}} \} \geq 1 - \alpha , (9)
где \chi_{n_{i} - 1,\alpha 2}^{2} ; \overline{\chi_{n_{i} - 1,\alpha 2}^{2}} — квантили, которые определяются по \chi^{2} с ni — 1 степенями свободы при уровне значимости \alpha = 0,05 .
Значения \chi^{2} представлены в табл. 1 приложения 3.
5.2. Чем больше взят объем выборки, тем выше надежность оценки, т.е. тем более узкий доверительный интервал может быть принят при оценке данных.
Значение наибольших Uтабл при (U_{x\prime<x} \leq U_{\text{табл}}) \leq \alpha = 0,05
1. Согласование данных нарушается, если вычисленное значение A2min превышает ожидаемое значение F согласно п. 4.1.
Для устранения несогласованности данных рекомендуется использовать расчетный коэффициент Берджа
R_{\text{Б}} = \sqrt{A_{min}^{2}F} . (1)
В этих случаях вычисленное по п. 3.6 значение среднего квадратического отклонения Si каждой i-й выборки общей выборки изменяют на RБ число, равное коэффициенту Берджа, и находят измененные значения среднего квадратического отклонения S'i каждой i-й выборки:
с помощью которых, аналогично величине A2min, вновь вычисляют величину A_{1min}^{2} согласно п. 4.1.
Если вычисленное значение A_{1min}^{2} не превышает ожидаемое F (при \alpha = 0,05 ), то согласованность данных принимается.
2. В случае, если необходимо вычислить коэффициент Берджа Ri для каждой i-й выборки, используют следующую формулу:
R_{i} = \frac{\sqrt{\sum_{i = 1}^{n_{i}} (x_{i} - \overline{x_{i}})^{2}S_{i}^{2}}}{n_{i} - 1} . (3)
Затем находят измененные оценки дисперсий (S«i)2 каждой i-й выборки»
и вычисляют величину A_{2min}^{2}
A_{2min}^{2} = \sum_{i = 1}^{L} \frac{(\overline{x_{i}} - \overline{x}\prime)^{2}}{(S_{i}\prime\prime)^{2}} , (5)
где \overline{x} — среднее взвешенное, вычисленное с помощью измененных оценок (S«i)2, согласно п. 4.1.»
Согласованность данных принимается, если сумма квадратов относительных изменений оценок дисперсий (S«i)2 минимальна:»
\sum_{i = 1}^{L} [1 - (S_{i}\prime\prime S_{i}^{2})] = min
Значение \chi^{2} в зависимости от вероятности P и числа степеней свободы с (ni — 1) \chi_{n_{i} - 1}^{2} — распределение \chi^{2}
Обработка данных, полученных при определении плотности топлива ТС-1 по ГОСТ 3900-47
| УДК 665.6 : 53.081.7 |
|---|