ГОСТ Р ИСО 24615-2016. Национальный стандарт Российской Федерации. Управление языковыми ресурсами. Система синтаксического аннотирования (SynAF)
Актуально на 01.11.2026.
Как цитировать: "ГОСТ Р ИСО 24615-2016. Национальный стандарт Российской Федерации. Управление языковыми ресурсами. Система синтаксического аннотирования (SynAF)". ГОСТ Р ИСО 24615-2016. https://bukva.ai/docs/gost-r-iso-24615-2016
(утв. и введен в действие Приказом Росстандарта от 30.11.2016 № 1904-ст)
Примечание
Документ введен в действие с 01.09.2017.
Утвержден и введен в действие
Приказом Федерального
агентства по техническому
регулированию и метрологии
от 30 ноября 2016 г. № 1904-ст
НАЦИОНАЛЬНЫЙ СТАНДАРТ РОССИЙСКОЙ ФЕДЕРАЦИИ
УПРАВЛЕНИЕ ЯЗЫКОВЫМИ РЕСУРСАМИ
СИСТЕМА СИНТАКСИЧЕСКОГО АННОТИРОВАНИЯ (SynAF)
Language resource management.
Sintactic annotation framework (SynAF)
1 сентября 2017 года
Предисловие
1 ПОДГОТОВЛЕН Автономной некоммерческой организацией «Институт безопасности труда» (АНО «ИБТ») на основе собственного перевода на русский язык англоязычной версии международного стандарта, указанного в пункте 4
2 ВНЕСЕН Техническим комитетом по стандартизации ТК 55 «Терминология, элементы данных и документация в бизнес-процессах и электронной торговле»
3 УТВЕРЖДЕН И ВВЕДЕН В ДЕЙСТВИЕ Приказом Федерального агентства по техническому регулированию и метрологии от 30 ноября 2016 г. № 1904-ст
4 Настоящий стандарт идентичен международному стандарту ИСО 24615:2010 «Управление языковыми ресурсами. Система синтаксического аннотирования (SynAF)» (ISO 24615:2010 «Language resource management — Sintactic annotation framework (SynAF)», IDT).
При применении настоящего стандарта рекомендуется использовать вместо ссылочных международных стандартов соответствующие им национальные стандарты, сведения о которых приведены в дополнительном приложении ДА
Правила применения настоящего стандарта установлены в статье 26 Федерального закона от 29 июня 2015 г. № 162-ФЗ «О стандартизации в Российской Федерации». Информация об изменениях к настоящему стандарту публикуется в ежегодном (по состоянию на 1 января текущего года) информационном указателе «Национальные стандарты», а официальный текст изменений и поправок — в ежемесячном информационном указателе «Национальные стандарты». В случае пересмотра (замены) или отмены настоящего стандарта соответствующее уведомление будет опубликовано в ближайшем выпуске информационного указателя «Национальные стандарты». Соответствующая информация, уведомление и тексты размещаются также в информационной системе общего пользования — на официальном сайте Федерального агентства по техническому регулированию и метрологии в сети Интернет (www.gost.ru)
Введение
Настоящий стандарт основан на многочисленных проектах и рабочих материалах, предшествовавших этапу стандартизации, которые разрабатывались в течение 1990-х годов [9] и касались создания эталонных моделей и форматов представления синтаксической информации, являющейся результатом работы синтаксического анализатора или аннотациями языковых ресурсов (в банках древовидных структур). На протяжении ряда лет стандартом де-факто для построения банков древовидных структур служил проект инициативной группы Пенсильванского университета Penn Treebank; однако более поздние работы, например инициативные проекты Negra/Tiger в Германии (см: http://www.ims.uni-stuttgart.de/projekte/TIGER/TIGERCorpus/) и ISST в Италии [18], продемонстрировали практическую востребованность более однородной базовой системы, которая способна охватывать в равной степени как отношения иерархической соподчиненности компонентов, так и явление зависимости в синтаксическом аннотировании.
Основой для стандартизации стал проект «LIRICS» группы eContent, объединивший усилия множества экспертов, которые инициировали разработку проекта стандарта ИСО 24615 (по системе SynAF). На подготовительном этапе эта группа подтвердила, что в существующих инициативных проектах в действительности используется общая модель данных, которая обеспечивает добротную основу для построения метамодели SynAF [см. результаты проведенных исследований в информационном бюллетене Deliverable D.3.1 «Evaluation of initiatives for morpho-syntactic and syntactic annotation» («Оценка инициативных проектов в области морфосинтаксического и синтаксического аннотирования»)] в рамках проекта Евросоюза LIRICS, информацию о котором можно получить по адресу http://lirics.loria.fr/doc_pub/Del3_1_V2.pdf).
Настоящим международным стандартом предлагается метамодель для синтаксического аннотирования со списком релевантных категорий данных, которые она охватывает. Эти категории данных доступны на сервере ISOCat (http://www.isocat.org/) в синтаксическом профиле (определенном в соответствии с ИСО 12620:2009).
1 Область применения
В настоящем стандарте описывается система синтаксического аннотирования SynAF, являющаяся высокоуровневой моделью для представления синтаксической аннотации лингвистических данных с целью обеспечения возможности работы со всеми языковыми ресурсами или компонентами обработки языковых данных. Настоящий стандарт является дополнением ИСО 24615, тесно связан с ним в части схемы морфосинтаксического аннотирования MAF (morpho-syntactic annotation framework) и представляет метамодель для синтаксических представлений, равно как и эталонные категории данных для представления информации по составляющим элементам и отношениям зависимости в сложных предложениях или других сопоставимых высказываниях и сегментах.
2 Нормативные ссылки
В настоящем стандарте использованы нормативные ссылки на следующие стандарты (для датированных ссылок необходимо применять только указанное издание ссылочного стандарта, для недатированных — последнее издание, включая все поправки к нему).
ISO 1087-1:2000, Terminology work — Vocabulary — Part 1: Theory and application (Терминологическая работа. Словарь. Часть 1. Теория и применение)
ISO 1087-2:2000 <*>, Terminology work — Vocabulary — Part 2: Computer application (Терминологическая работа. Словарь. Часть 2. Применение вычислительной техники)
ISO 12620:2009 <**>, Terminology and other language and content resources — Specification of data categories and management of a Data Category Registry for language resources (Терминология, другие языковые ресурсы и ресурсы содержания. Спецификация категорий данных и ведение реестра категорий данных для языковых ресурсов)
ISO 24611, Language resource management — Morpho-syntactic annotation framework (MAF) (Управление языковыми ресурсами. Морфосинтаксическая аннотационная система)
3 Термины и определения
В настоящем стандарте применены термины по ИСО 1087-1, ИСО 1087-2, ИСО 12620:2009, ИСО 24611, а также следующие термины с соответствующими определениями:
3.1 обстоятельственное слово, обстоятельство, адъюнкт (adjunct): Второстепенный элемент, ассоциируемый с глаголом в отличие от синтаксических аргументов (3.19).
Примечание - В качестве обстоятельственных слов в предложении могут выступать наречия.
3.2 фрагмент (chunk): нерекурсивная составляющая (3.4).
3.3 элементарное предложение (clause): Группа фраз (3.14), обычно содержащая некоторое высказывание.
Примечание — Предложение может быть главным (3.10) или придаточным (3.17). В тех языках, где существует понятие законченности действия, глагол в предложении с глагольным сказуемым может быть совершенного или несовершенного вида — в зависимости от его конкретной формы. Главное предложение само по себе может представлять сложное высказывание (3.15). В модели SynAF предложение является особой формой составляющей (3.4).
3.4 составляющая, конституента (constituent): Синтаксическая группировка слов [во фразах (3.14)], фраз [в предложениях (3.3) либо в других фразах] или элементарных предложений [в сложном предложении (3.15)], основанная на их структурных (или иерархических) свойствах.
3.5 зависимость, отношение зависимости (dependency, dependency relation): Синтаксическая связь между словоформами (3.24) или конституентами (3.4), устанавливаемая на основе грамматических функций (3.7), которые конституенты выполняют по отношению друг к другу.
3.6 (синтаксическая) дуга (syntactic edge, edge): Триплет, образуемый исходным узлом (3.12), целевым узлом и необязательными аннотациями (3.9).
Примечание — Нетерминальные узлы (3.13) имеют исходящую дугу синтаксической конституентности.
3.7 грамматическая функция (grammatical function): Грамматическая роль словоформы (3.24) или конституенты (3.4) в синтаксической среде, в которую они погружены.
Примечание — Например, именная группа (NP) или имя существительное внутри сложного предложения может действовать как подлежащее (3.15) - соответственно положению глагола в графе отношения подчинения. Между именной группой как подлежащим и основным глаголом предложения существует грамматическая связь. Все грамматические отношения (подлежащее — сказуемое, вершина — модификатор и т.п.) категоризируются в соответствии с концептом отношения зависимости (3.5) между терминальными и нетерминальными узлами.
3.8 синтаксическая вершина, вершина, главное слово (syntactic head, head): Часть конституенты (3.4), определяющая ее дистрибуцию (синтаксическое окружение, в котором может появляться конституента) и грамматические характеристики (например, если грамматический род главного слова — женский, то род конституенты в целом тоже будет женским).
Примечание - Опущение главного слова конституенты, как правило, не допускается.
3.9 (лингвистическое) аннотирование (linguistic annotation, annotation): Пара «элемент — значение», представляющая лингвистическое свойство лингвистического сегмента.
3.10 главное предложение (main clause): Предложение (3.3), которое само по себе может выступать в качестве законченного высказывания (3.15).
Примечание - В языках, предусматривающих различение завершенности и незавершенности действия, главное предложение обычно является законченным высказыванием, например «Поезд опаздывает».
3.11 модификатор, определение (modifier): Часть конституенты (3.4), описывающая свойство ее вершины (3.8).
Примечание — Модификатор может помещаться до или после вершины фразы (3.14) (премодификатор или постмодификатор). Модификаторы в конституенте не обязательны.
3.12 синтаксический узел (node syntactic, node): Словоформа (3.24) или конституента (3.4), рассматриваемая как элементарный синтаксический компонент синтаксического анализа.
3.13 нетерминальный узел (non-terminal node): Синтаксический узел (3.12), не являющийся словоформой (3.24).
Примечание — Нетерминальный узел имеет исходящую дугу конституентности (3.6).
3.14 фраза, синтаксическая конструкция (phrase): Группа словоформ (3.24) (обычно состоящая из одного или нескольких слов), которая может выполнять определенную грамматическую функцию (3.7), например, в элементарном предложении (3.3).
Примечание — Допускается присутствие пустых фраз (представленных неопределенно-личными местоимениями); такие группы словоформ в английском языке иногда снабжаются пометой «pro» и в простых предложениях играют роль подлежащего). Группы словоформ, как правило, именуются по их главному слову, или вершине (3.8); например, могут быть именные группы, глагольные группы, группы прилагательного, наречные группы и предложные группы. В просторечии фразы характеризуются как «раздутые слова» в том смысле, что части фразы, добавляемые к главному слову (вершине), усложняют и конкретизируют его референцию. В нашей модели фраза представляет собой специальный случай конституенты (3.4).
3.15 сложное предложение, высказывание (sentence): Связанная группа словоформ (3.24), содержащая предикацию, которая обычно выражает законченную мысль и образует базовую единицу структуры дискурса.
Примечание — Сложное предложение состоит из одного или нескольких простых предложений (3.3). При описании речевого общения обычно говорят о «высказываниях», а не о предложениях.
3.16 интервал (span): Пара точек (p1, p2), где p1 <= p2, идентифицирующая сегмент документа, к которому применима аннотация (3.9).
Примечание - Многократный интервал — это цепочка интервалов, в которой координаты конечной точки каждого предшествующего интервала меньше или равны координатам начальной точки последующего интервала.
3.17 придаточное предложение (subordinate clause): Элементарное предложение, которое выполняет некоторую грамматическую функцию (3.7) в синтаксическом обороте (3.14) [например, функцию определительного предложения (3.3) для имени существительного, образующего вершину (3.8) именного словосочетания] или в другом предложении.
Примечание - Придаточное предложение обычно не самостоятельно, а является частью более длинного сложного предложения.
3.18 фрейм субкатегоризации (subcategorization frame): Набор ограничений, показывающих свойства синтаксических аргументов (3.19), которые могут или должны связываться с глаголом.
Пример - Альфред (/syntacticArgument/) читает книгу (/syntacticArgument/) сегодня (/adjunct/).
Примечание — Подлежащее, косвенное дополнение и прямое дополнение — это субкатегоризированные грамматические функции (3.7) внутри предложения; они подчиняются глаголу (то есть могут появляться во фреймах субкатегоризации).
3.19 синтаксический аргумент (syntactic argument): Важный функциональный элемент, запрашиваемый и интерпретируемый вершиной его синтаксической конструкции (3.14) или узлом (3.12), от которого он зависит (примером может служить именной аргумент предложной группы или глагол).
Примечание - Для глаголов и глагольных конструкций аргументы идентифицируют стороны процесса, на который указывает глагол. В некоторых объектных структурах синтаксические аргументы называются дополнениями.
3.20 (синтаксический) граф (syntactic graph, graph): Связанное множество синтаксических узлов (3.12) и дуг (3.6).
3.21 синтаксическое дерево (syntactic tree): Синтаксический граф (3.20), в котором каждый из узлов имеет единственный родительский узел.
3.22 синтаксис, синтаксические правила (syntax): Способ соединения и/или группирования словоформ (3.24) в синтагмы для сбора информации о существующих отношениях между группируемыми единицами.
3.23 терминальный узел (terminal node): Синтаксический узел (3.12), являющийся одиночной словоформой (3.24) или пустым элементом синтаксического отношения.
3.24 словоформа (word form): Непрерывный или сегментированный объект речевого или текстового оборота, идентифицируемый как автономная лексема.
4 Метамодель SynAF
4.1 Вводные замечания
В когнитивной обработке языковых данных синтаксические аннотации выполняют как минимум две функции:
a) представление лингвистической конституентности [подобно именным группам (NP)], описывающей структурированную последовательность морфосинтаксически аннотированных лексем (включая пустые элементы или следы, порожденные передвижениями на уровне составляющих), а также построение составляющих из сегментированных элементов;
b) представление отношений зависимости: например, отношения «главное слово — модификатор» и отношения между категориями одного вида (подобные связям между главными словами в именных аппозициях или именным соподчинениям в некоторых формализмах). Внутри синтаксической группы может существовать информация о зависимости между элементами, прошедшими этап морфосинтаксического аннотирования (например, прилагательное — это модификатор главного существительного внутри именной группы), или описываться конкретное отношение между синтаксическими составляющими на клаузальном и пропозициональном уровнях (то есть там, где именная группа выступает как «субъект» основного глагола элементарного или сложного предложения). Отношение зависимости может устанавливаться также для пустых элементов (например, для элемента pro в романских языках, где этот элемент выполняет грамматическую функцию).
Как следствие синтаксические аннотации должны соответствовать многоуровневой стратегии аннотирования, обеспечивающей взаимосвязь синтаксического аннотирования по составляющим элементам и по отношениям зависимости, как это установлено в метамодели SynAF.
4.2 О метамодели SynAF
4.2.1 Общий обзор
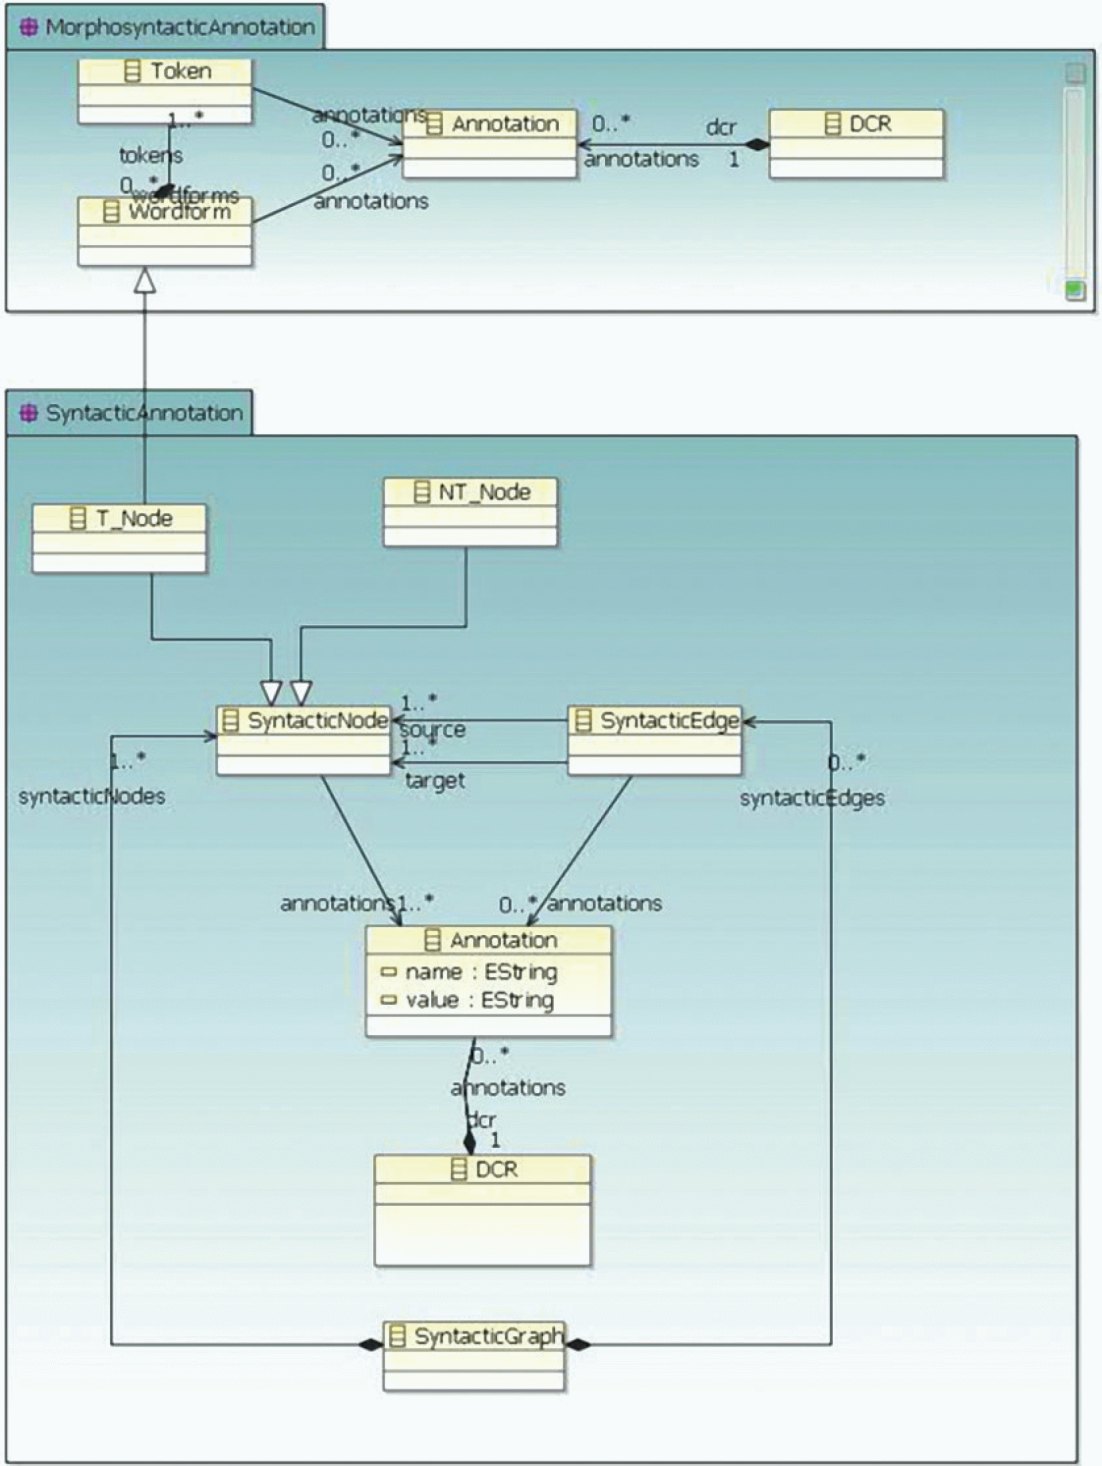
Метамодель SynAF представляется как совокупность классов универсального языка моделирования UML, дополненная UML-парами «атрибут — значение», которые представляют соответствующие категории синтаксических данных. Текстовые описания SynAF определяют более полную информацию о классах SynAF, отношениях и расширениях, которые могут быть включены в диаграмму UML. Разработчики должны определить выбор категории данных (DCS) в соответствии с процедурами выбора категорий данных, установленными для SynAF (см. рисунок 1). Для представления синтаксических аннотаций следует применять категории данных, указанные в приложении A.
4.2.2 Класс SyntacticNode
SyntacticNode — это параметризованный класс, категоризирующий как класс терминальных узлов, так и класс нетерминальных узлов. Синтаксические узлы могут быть задействованы в любом необходимом числе синтаксических отношений (см. 3.6, синтаксические дуги).
4.2.3 Класс T_Node
Класс T_Node представляет терминальные узлы синтаксического дерева, состоящего из словоформ, прошедших этап морфосинтаксического аннотирования, а также из пустых элементов, когда они необходимы. Узлы этого класса определяются на одном интервале или на множестве интервалов (множественные интервалы обеспечивают учет нарушений непрерывности составляющих частей текста). Для аннотирования узлов T_Nodes используются средства автоматической синтаксической категоризации, действующие на уровне отдельных слов.
4.2.4 Класс NT_Node
Класс NT_Node представляет нетерминальные узлы синтаксического дерева. Синтаксические деревья состоят в основном из узлов T_Nodes и NT_Nodes, а также пустых элементов, когда они необходимы. Узлы T_Nodes make reference to a span. Так с помощью древовидного синтаксического представления могут быть получены интервалы и для NT_Nodes. Для аннотирования узлов NT_Nodes используются средства автоматической синтаксической категоризации, действующие на уровне фраз и на более высоких уровнях (клаузальном и сентенциальном).
4.2.5 Класс SyntacticEdge
Класс SynacticEdge представляет отношение между синтаксическими узлами (как терминальными, так и нетерминальными). Например, отношение зависимости — это бинарное отношение, образуемое парой узлов — исходным и целевым, с одной или большим числом аннотаций. В частности, синтаксическая дуга может аннотироваться по типу /syntacticEdgeType/ (см. приложение A), концептуальной областью которого может быть одна из двух дуг: /primarySyntacticEdge/ либо /secondarySyntacticEdge/, но не только эти дуги.
4.2.6 Класс Annotation
Класс Annotation представляет результат применения синтаксической информации к аннотированным данным SynAF, а также (см. рисунок 1) применение морфосинтаксической информации к данным, прошедшим этап морфосинтаксического аннотирования (MAF).
Приведенные ниже категории данных должны использоваться для представления синтаксических аннотаций в сочетании с метамоделью SynAF. При необходимости в конкретных приложениях могут определяться дополнительные категории данных, которые должны описываться в соответствии с требованиями ИСО 12620 и регистрироваться в реестре категорий данных ISOCat.
A.3 Категории данных, относящиеся к свойству конституентности
A.4 Категории данных, связанные с отношениями
СВЯЗЬ С СИСТЕМОЙ ЛИНГВИСТИЧЕСКОГО АННОТИРОВАНИЯ
Для реализации системы SynAF необходимо руководствоваться требованиями ИСО 24612 к системе лингвистического аннотирования (LAF — Linguistic Annotation Framework). LAF обеспечивает общую основу для представления аннотаций, описанную в работах Айда (Ide) и Ромари (Romary) [14], [15], [16]. Разработка этой основы строилась на достижениях сложившейся практики и обобщении различных принципов лингвистического аннотирования, использовавшихся на протяжении последних 15 — 20 лет. Ядром системы является спецификация опорной абстрактной модели, из которой получаются аннотации, ориентированные на конкретные цели информационного обмена.
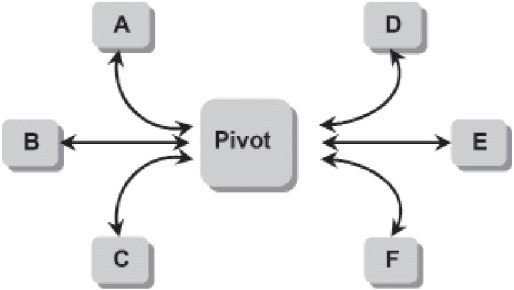
Рисунок B.1 — LAF как базовый формат
Рисунок B.1 иллюстрирует принципы использования LAF применительно к шести различным форматам пользовательских аннотаций (с метками от A до F), которые требуют двух преобразований для каждой схемы: одно — для отображения в базовый формат и одно — для преобразования из базового формата, представленного разработчиком схемы. Следовательно, максимальное число схемных преобразований составит 2n в отличие от (n2 — n) преобразований при отсутствии базового формата.
Для преобразования к опорной модели схема аннотирования должна быть изоморфна абстрактной модели (или сделана таковой в процессе преобразования); эта модель состоит, во-первых, из эталонной структуры для привязки внешних аннотаций к первичным данным, представленной ориентированным графом (орграфом), и, во-вторых, из представления структуры свойств содержимого аннотации. Таким образом, аннотация представляет собой орграф ссылок на n-мерные области первичных данных, равно как и на другие аннотации; в этом графе узлы аннотируются структурами элементов, которые, в свою очередь, формируют содержимое (контент) аннотации. Формально LAF включает в себя следующие компоненты:
- модель данных для аннотаций, основанную на вышеуказанных орграфах и определенную как граф аннотаций: граф аннотаций G — это совокупность вершин V(G) (термин «вершина» является синонимом термина «узел») и множества дуг E(G). Вершины и дуги могут снабжаться одним или несколькими свойствами. Свойство определяется четверкой элементов (G', VE, K, V), где G' — это граф, VE — вершина в G', K — имя свойства и V — значение свойства;
- первичные данные с базовой сегментацией, которая определяет дуги, идущие от одного виртуального узла к другому и расположенные между «символами» первичных данных, где символ определяется как смежная байтовая последовательность конкретной длины (по умолчанию для текста принимается значение UTF-16). Результирующий граф G трактуется как реберный граф G', узлами которого являются дуги графа G и который представляется листовыми («стоковыми») вершинами. Эти вершины образуют основу для однослойного или многослойного аннотирования. Над первичными данными может определяться множество сегментаций, а одна и та же сегментация может соотноситься с множественными аннотациями;
- публикации модели данных, одна из которых обозначается как опорная;
- методы манипулирования моделью данных.
Следует иметь в виду, что LAF не порождает спецификаций для категорий содержимого аннотаций (то есть аннотаций, описывающих соответствующие лингвистические явления); стандартизация таких аннотаций требует гораздо более сложных разработок. Архитектура LAF ориентирована на взаимодействие с реестром категорий данных [Data Category Registry (DCR)], содержащим предопределенные элементы данных и схемы, которые могут использоваться непосредственно в аннотациях вместе со средствами определения новых категорий и модификации существующих [14], [15].
| Обозначение ссылочного международного стандарта | Степень соответствия | Обозначение и наименование соответствующего национального стандарта |
| ISO 1087-1 | - | <*> |
| ISO 1087-2 | - | <*> |
| ISO 12620 | IDT | ГОСТ Р ИСО 12620-2012 «Терминология, другие языковые ресурсы и ресурсы содержания. Спецификация категорий данных и ведение реестра категорий данных для языковых ресурсов» |
| ISO 24611 | - | <*> |
| <*> Соответствующий национальный стандарт отсутствует. До его утверждения рекомендуется использовать перевод на русский язык данного международного стандарта. Перевод данного международного стандарта находится в Федеральном информационном фонде стандартов. Примечание — В настоящей таблице использовано следующее условное обозначение степени соответствия стандартов: - IDT — идентичные стандарты. | ||
| УДК 658:562.014:006.354 | ОКС 01.020, 35.240.60 |
| Ключевые слова: атрибут, синтаксическое дерево, синтаксис, терминальный узел, словоформа, синтаксическая конструкция, нетерминальный узел, аннотирование | |